1. RNA 数据准备:让 412 例肿瘤成为可信的分析起点
本章用 Omicos 整理 TCGA-STAD RNA-seq 数据,保留下载快照中的全部合格原发肿瘤。
这一步想知道什么
下载的表达矩阵不能直接分析:数值取过对数吗?行名能被后续方法识别吗?一个患者有没有重复出现?本章把这些问题查清楚,留下可靠的表达数据和样本表——后面每一章都从这里读数据。
可以这样问
按导读准备好输入、新建对话后,发送:
请用 iobrx 处理 iobrx_skill_tutorial/inputs 中的 TCGA-STAD 公开输入
(来源与单位见其中 DATA.md),核对数据尺度后完成数据准备:
还原 counts、计算 TPM、整理样本表、画质控图和 PCA。尽可能保留完整
原发肿瘤队列,正常组织用于质控;不参考其他案例的脚本或结果。
产物保存到 iobrx_skill_tutorial/results/01_rna,用中文解释数据取舍。
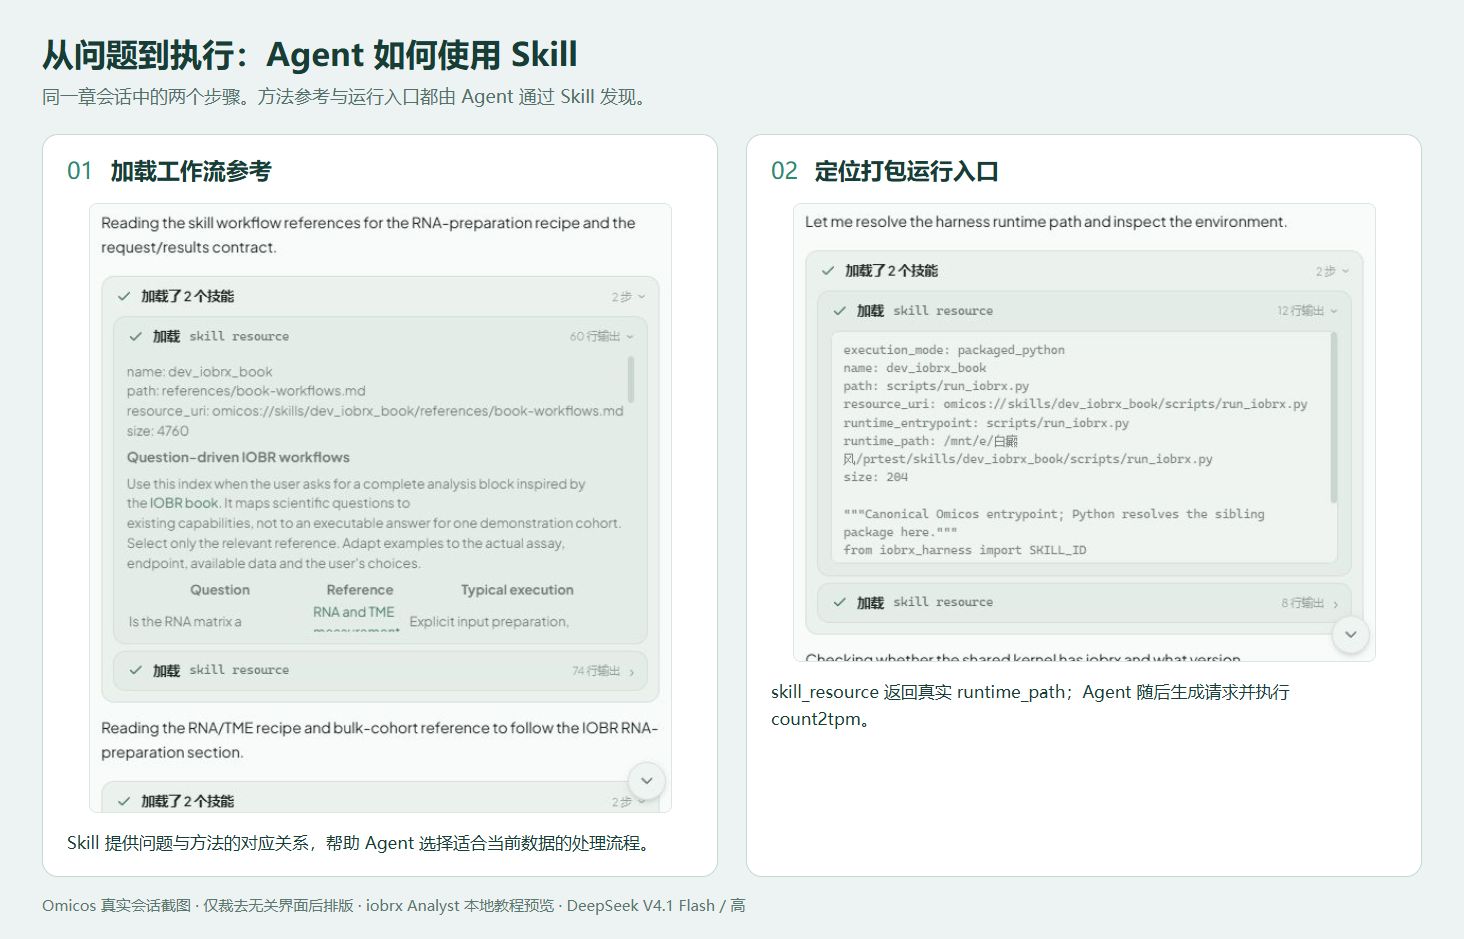
Omicos 中的 iobrx Analyst 会从 Skill 中找到处理方法和 harness 入口,调用 count2tpm 完成换算,再整理样本表和绘图。下图展示了实际的 Skill 加载与入口解析:
结果怎么看
先看样本和基因各剩多少。
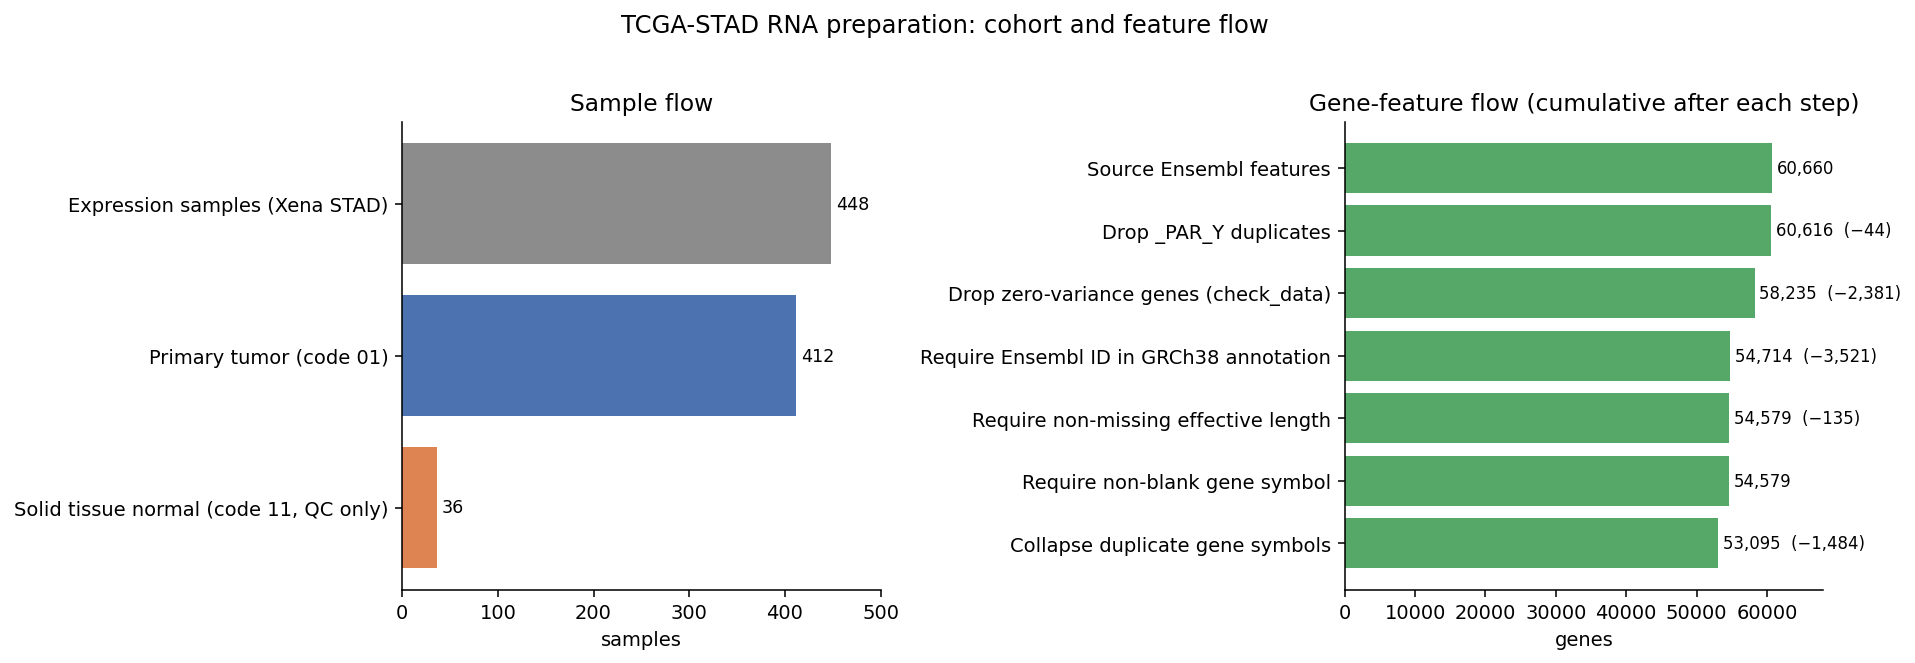
左图:448 份表达数据中有 412 份原发肿瘤、36 份正常组织。412 份肿瘤恰好来自 412 位不同患者,全部保留;正常组织只用于质控,其中 33 份与肿瘤来自同一患者,不能把它们理解成另外招募的健康人群。右图:60,660 行输入经过重复条目处理、全零基因筛选、注释匹配和同名合并,剩 53,095 个唯一基因名。这些步骤减少的是行,412 列肿瘤没有减少。本次有 135 个基因因缺少有效长度未参与 TPM 换算——运行警告只描述这一步,完整的逐步去留记录在 metadata/gene_flow.csv。
再弄清两份表达矩阵的区别。 这份 Xena GDC 数据的原始数值是 log2(count+1),所以 Agent 先还原成 counts(原始测序计数),再换算成 TPM——TPM 按基因长度和样本总量校正,让不同样本的表达值可以比较。本章同时交付 TPM 和 log2(TPM+1) 两份矩阵:后续方法要线性 TPM 就用前者,要对数表达就用后者,不能因为看见小数就再取一次对数。
然后看质控图。
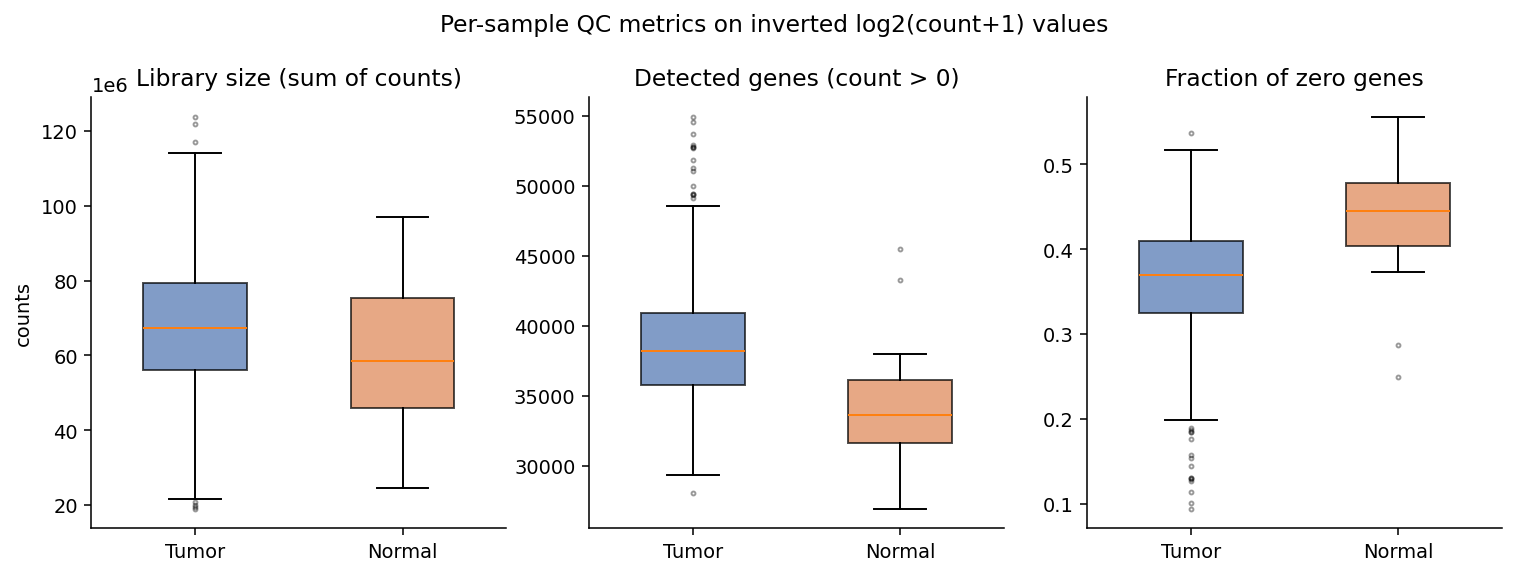
三个面板分别展示还原 counts 的总量、检出基因数和零值比例。箱体是中间一半样本的范围,中线是中位数。肿瘤组文库总量中位数约 6,731 万,正常组约 5,863 万;两组有重叠也有差异,这张图不能单独说明差异来自测序、取材还是细胞组成。本次有 5 份肿瘤触发质控规则(文库量或检出基因数偏低),仍保留在分析中——质控标记是线索,不是删除指令。
最后看 PCA 图。 PCA(主成分分析)把上万个基因的变化压缩成少数几个方向,方便一眼看样本分布。
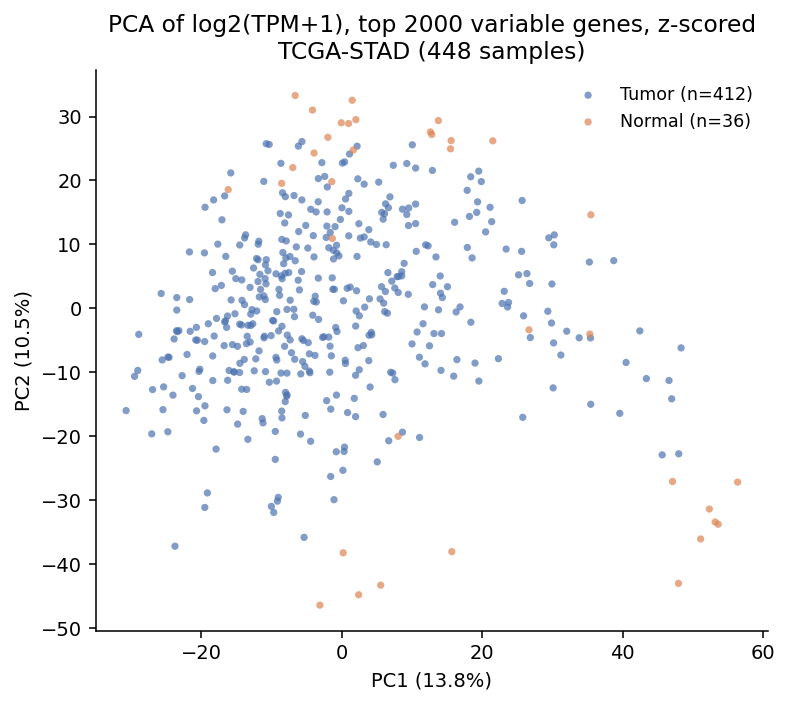
每个点是一份样本,本次取变异最大的 2,000 个基因计算,PC1 和 PC2 分别解释约 13.8% 和 10.5% 的变异。两组分布有差别也有重叠。PCA 只展示变化最大的方向,没有拿"肿瘤/正常"标签训练分类器,不能把某个位置的点直接判为异常。
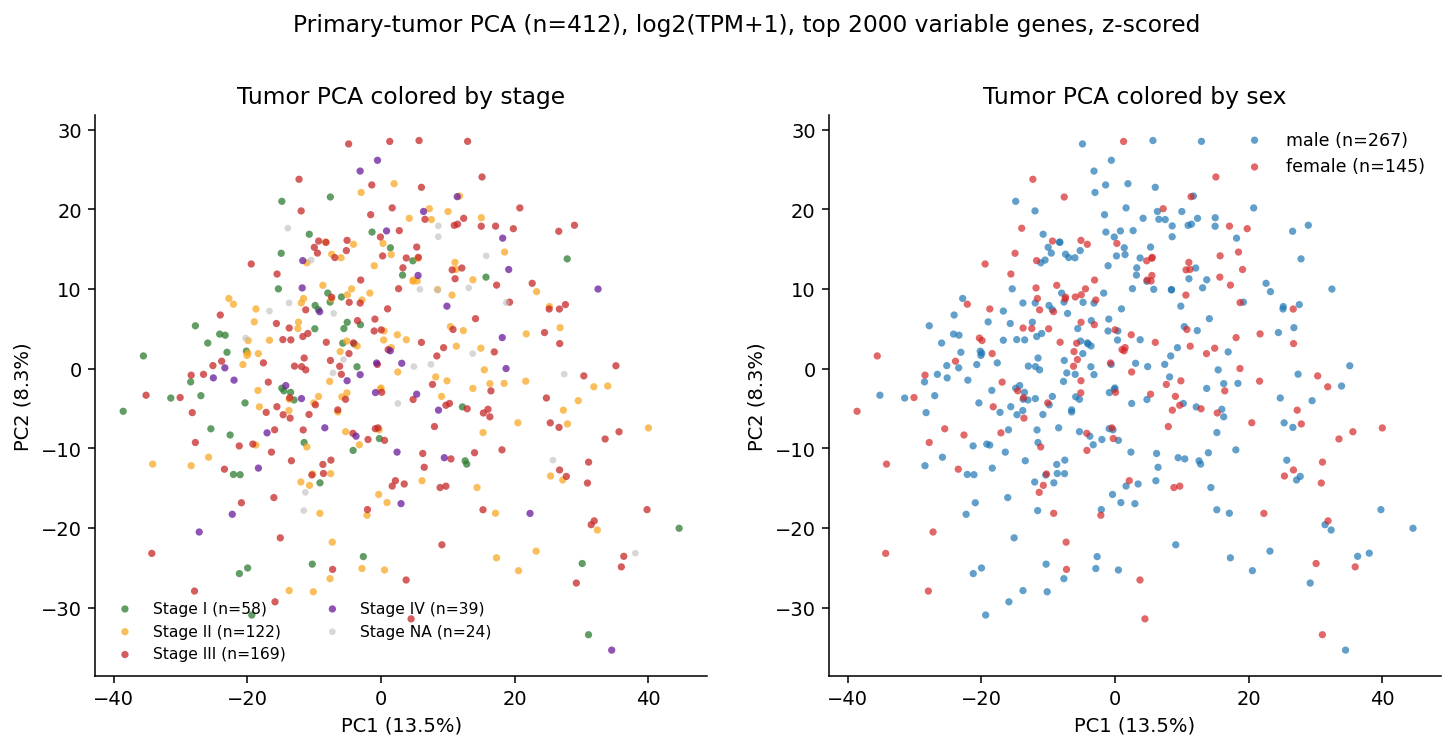
只看 412 例肿瘤时,各分期和性别在前两个主成分上明显混合。这说明这张二维投影没有区分开这些分组,并不说明分期没有影响——研究生存关联需要第 4 章那样的统计模型。
接下来怎么做
本章产物在 results/01_rna/:表达矩阵在 prepared/(TCGA-STAD.tpm.tumor.parquet 是 53,095×412 的线性 TPM,另有对应的 log 版本),样本表在 metadata/tumor_sample_metadata.csv(412 例中 388 例有分期、385 例有生存资料)。接着做第 2 章签名评分,它直接读取这里的表达矩阵。想先检查数据,可以问:"这几份被质控标记的样本,排除前后 PCA 图变化大吗?"
参考:IOBR RNA 数据处理方法;TCGA 胃癌研究,Nature 2014;IOBR 2.0,Cell Reports Methods 2024。输入准备与运行记录见数据与运行说明。