8. TME 建模:把预测放到没有见过的患者上检验
本章换用有真实免疫治疗反应记录的 IMvigor210 队列;前七章使用的 TCGA-STAD 资料没有这类标签。
这一步想知道什么
前面七章都在回答"特征之间有什么关联"。本章问另一个问题:把几个特征放进一个模型,能不能预测没见过的患者的治疗反应和生存?判断依据是留出测试患者上的表现,不是训练数据上的曲线。
可以这样问
用 iobrx_skill_tutorial/inputs 的 IMvigor210 签名和临床数据,
完成治疗反应与生存建模:选择可解释的特征,留出独立测试样本,
检查模型预测与实际结局是否相符。产物保存到
iobrx_skill_tutorial/results/08_modeling,用评估图、风险分层图和中文
解读说明效果、不确定性及使用范围。只使用该案例的公开输入,不参考
其他案例脚本或结果;不要把 TCGA 的生存标签当成治疗反应。
Omicos 的 iobrx Analyst 按 Skill 中的建模说明检查特征、标签和数据划分,调用统计工具完成训练、评估与绘图。
结果怎么看
先看两个预测问题各有多少人。 这是接受抗 PD-L1 治疗的尿路上皮癌队列,共 348 位患者。反应预测是二分类(实际是否缓解),用 298 人(68 缓解 / 230 未缓解;缺标签的 50 人只做生存);生存预测用全部 348 人(232 次死亡)。两者分别按 70%/30% 留出测试:反应 208/90,生存 243/105。
再看模型用了哪 5 个特征、各占多大权重。 特征是 CD8 效应、免疫检查点、Pan_F_TBRs(成纤维细胞 TGF-β 反应)、错配修复签名和肿瘤纯度估计——都是表达或估计信号,其中"错配修复"不是直接测定的 MSI 状态。
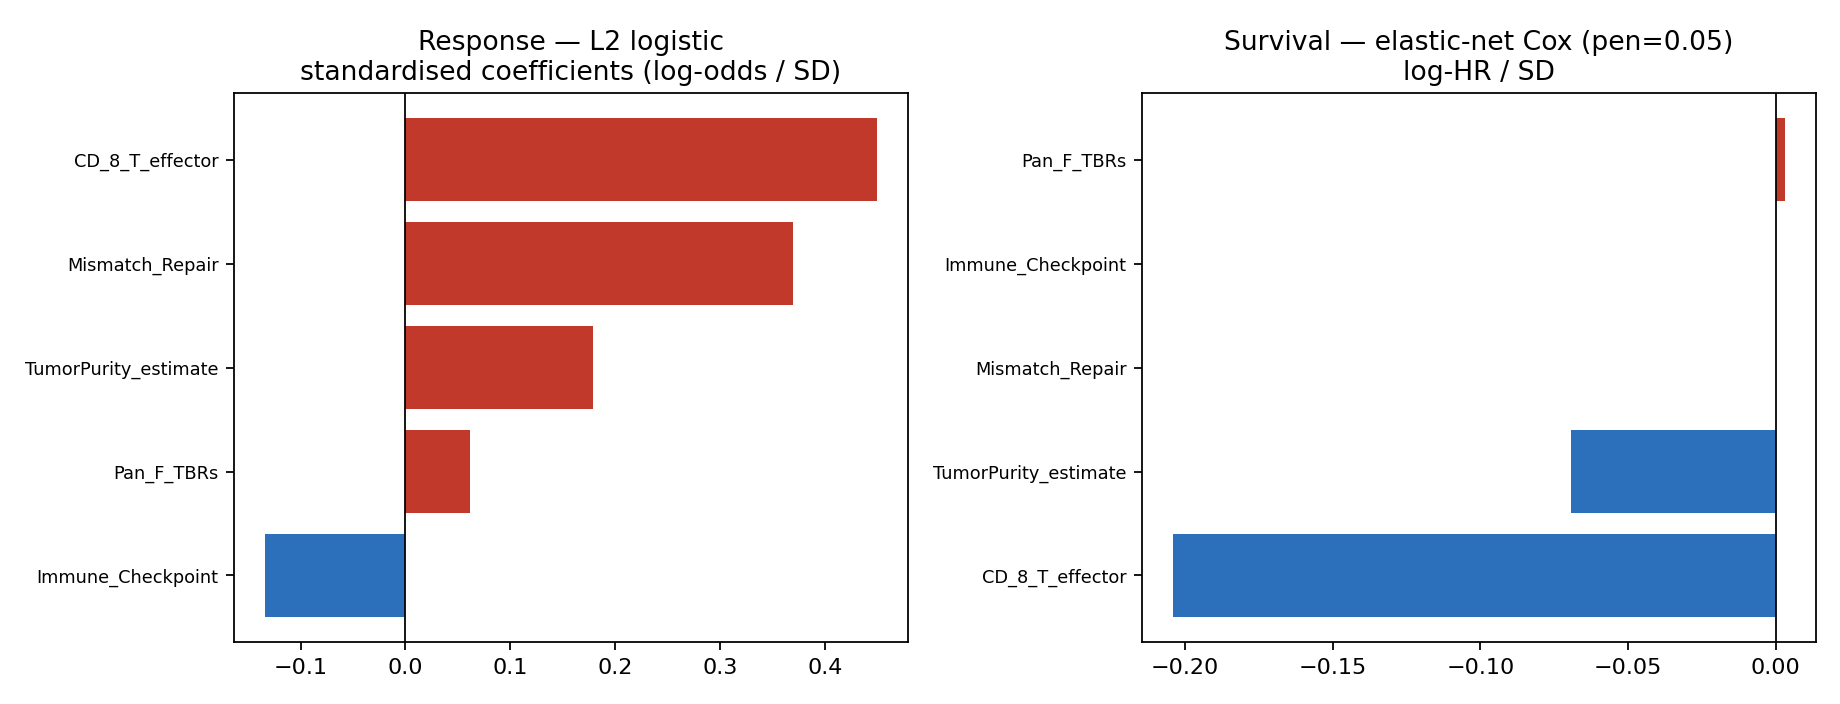
左半正系数表示反应几率随该特征升高而增加,右半负系数表示估计死亡风险随之降低;CD8 效应签名在两个模型中权重都较大。系数依赖其他输入和正则强度,不是各通路的因果作用大小。
然后看反应模型的评估图。
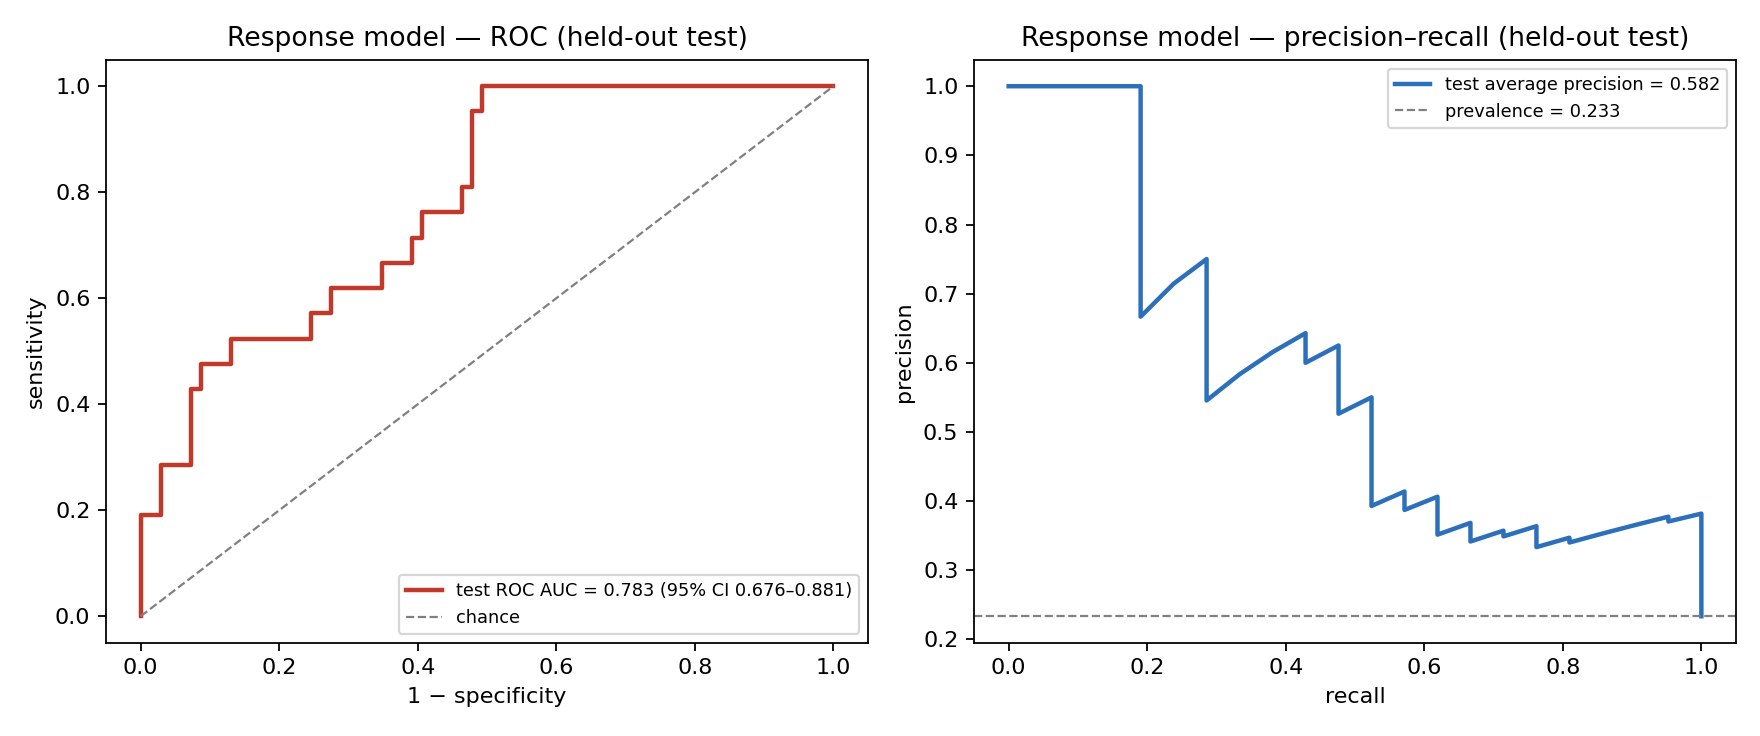
先看左图 ROC:测试 AUC 0.783(95% CI 0.676–0.881),说明模型对反应者有一定的排序能力。再看 PR 曲线的 AP 0.582——要和测试集实际反应率 23.3%(90 人中 21 人)比,而不是当成"58.2% 的准确率"。此外还有 Brier 分数 0.156(预测概率与真实标签的平方误差,越小越好;恒定预测训练反应率时为 0.179)。这些区间来自对固定测试预测的 2,000 次患者重抽样,描述这批测试患者带来的抽样不确定性。训练 AUC 为 0.712;测试值更高是小样本波动,不能据此说模型泛化"更好"。
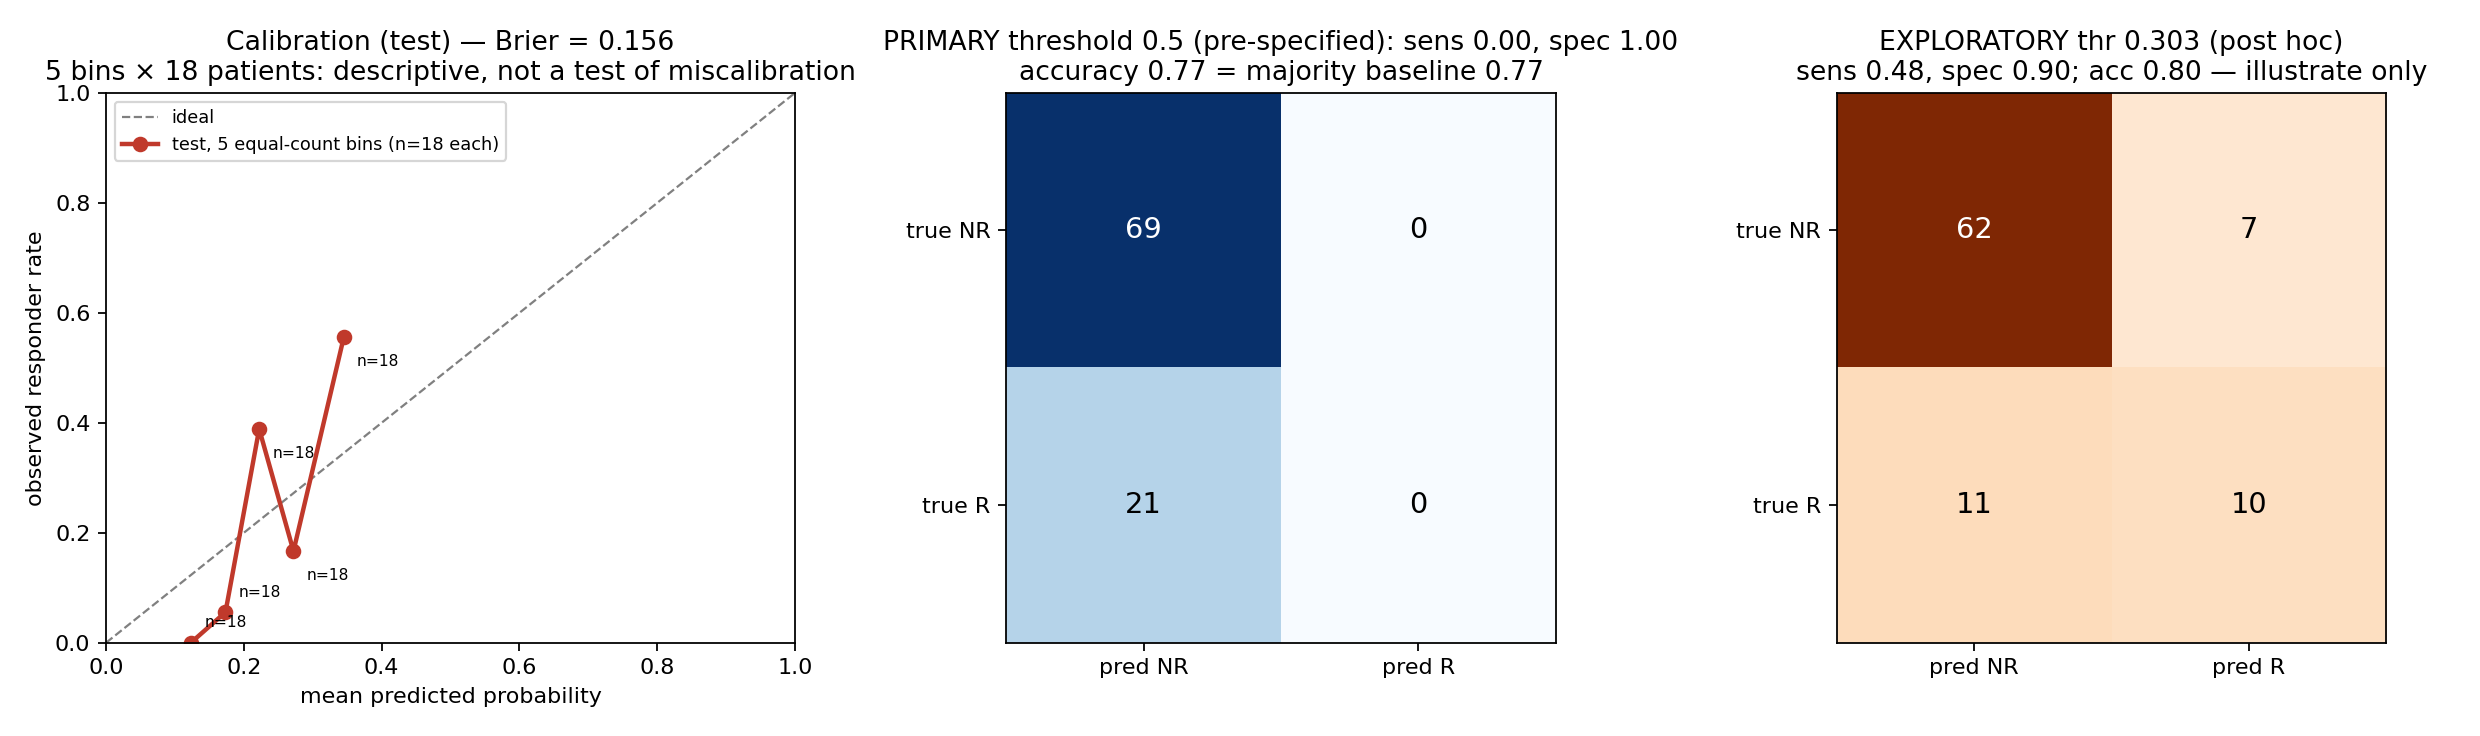
这张三联图最值得停在中间:按预设阈值 0.5,90 位患者全部被判为未缓解——准确率 76.7%,恰好等于"全部猜多数类"。AUC 尚可不代表默认阈值可用。右图演示阈值 0.303 时识别 10 位反应者、误判 7 位非反应者;这个阈值是看到 0.5 的结果之后才补做的探索性示例,不是预先确定的主结果,也不代表临床用药标准。左图校准每箱只有 18 人,提示概率校准还需更多数据检验。
最后看生存模型。
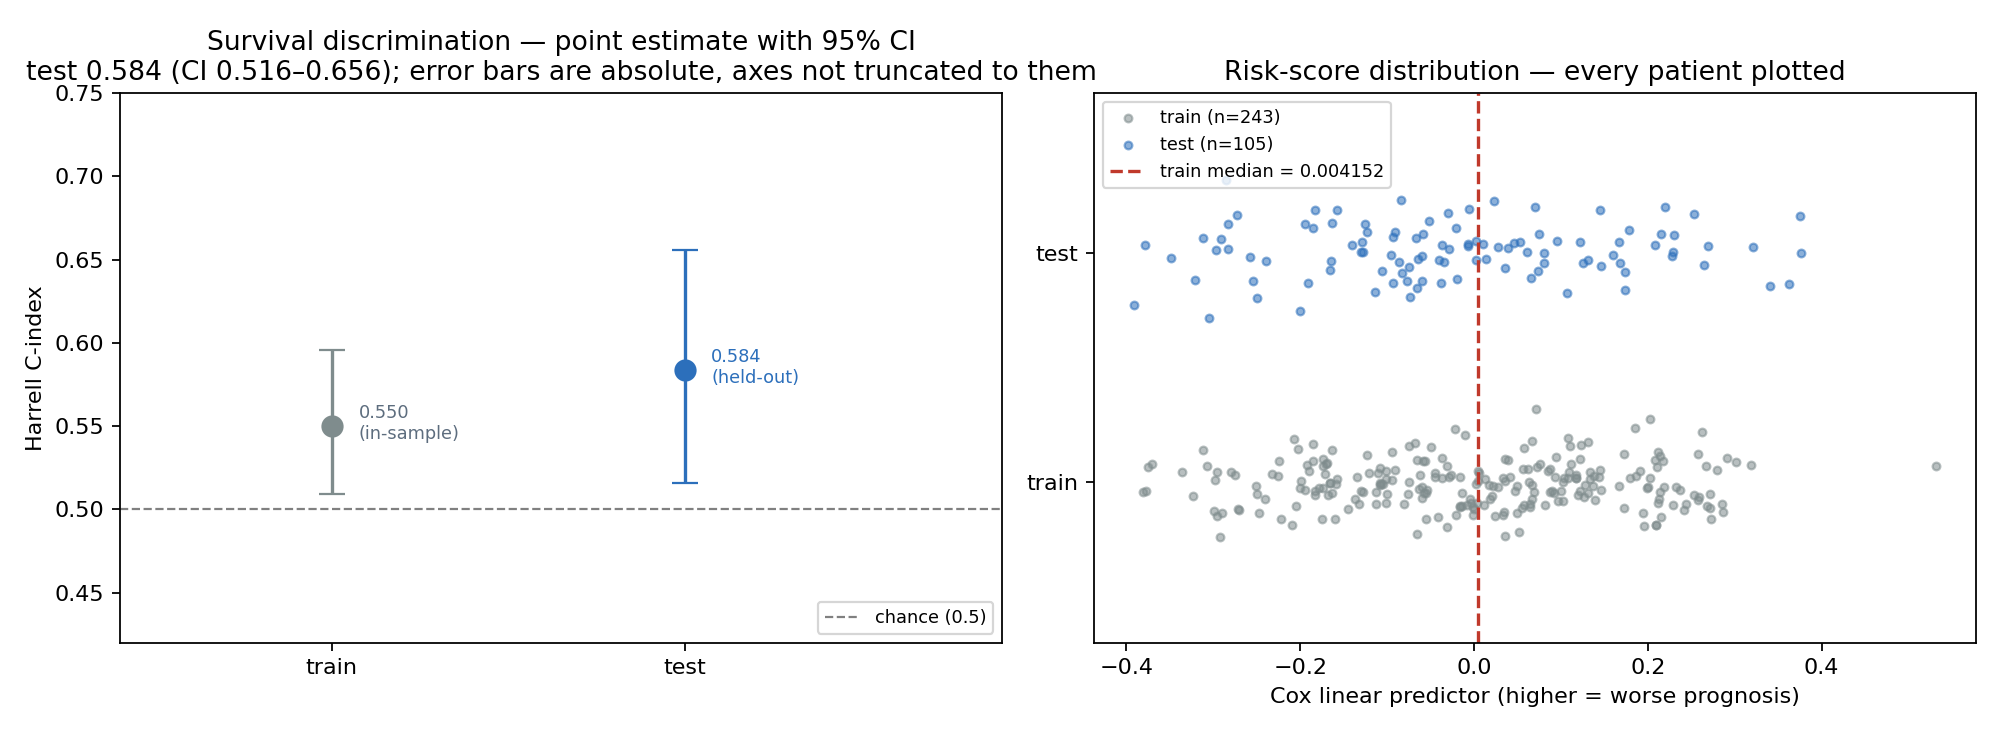
测试 C-index 0.584(0.516–0.656),训练集为 0.550——风险排序能力有限,不能说模型预测了个人的生存时长。按训练集阈值(0.004152)把测试集分成 63 低 / 42 高风险两组:
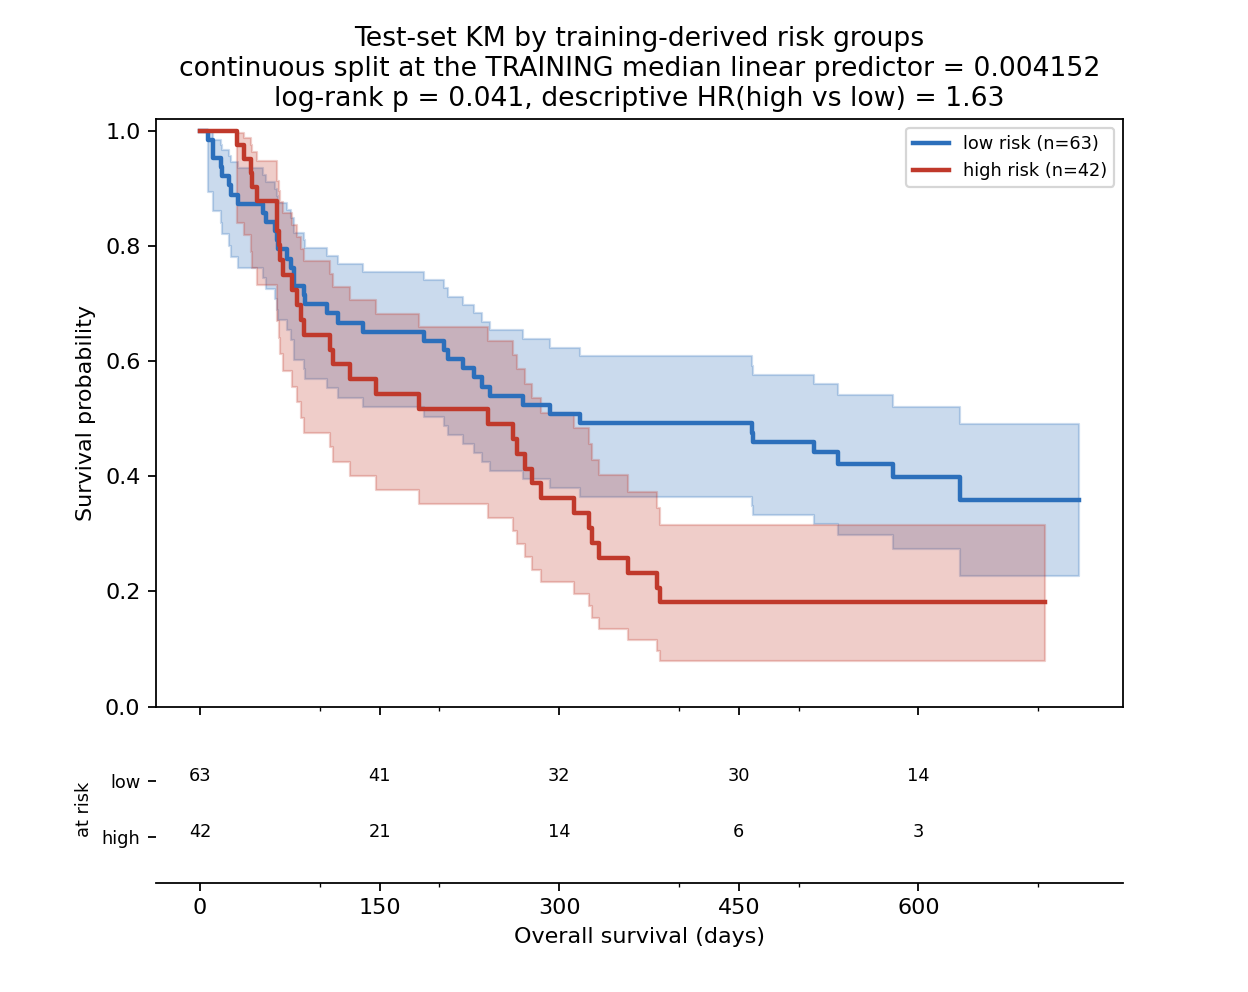
两组 log-rank P=0.041,和"连续风险排序区分度较弱"可以同时成立;不能用这个 P 值替代 C-index。600 天时两组还在观察的只剩 14 和 3 人,曲线尾部要结合置信区间读。训练诊断还提示个别变量的比例风险假设存疑(CD8 效应签名与纯度估计的名义 P 较低),需要进一步检查——本章如实保留了这些信号。
接下来怎么做
这次得到的是一个可检查、可继续研究的建模起点:反应模型有排序信息但默认阈值不合适,生存模型区分度较弱。这是同一队列内的留出评估,不是来自另一项研究的外部验证;模型从预计算签名出发,也没有覆盖从原始 RNA 到签名的完整流程,不能直接用于胃癌或其他治疗方案。
想继续推进,可以问:"换一个随机种子重新划分训练/测试,AUC 和 C-index 会变化多少?"本章保存了模型、划分和预测,重新加载能再现原测试预测;文件清单见数据与运行说明。