03 · 相似分子怎样分组?活性预测怎样检验?
分子很多,不一定代表结构足够多样。先看看数据里有哪些相近系列,再检验模型能否预测没用于训练的分子。本节分别做活性分类与 pIC50 回归,也比较随机划分和按骨架分组的划分。
发什么提示词
新建对话,选择 CADD Workflow Runner。
发送:
请分析 EGFR 的公开活性数据;如果当前对话没有数据,请自行从 ChEMBL 获取。分析化学空间,训练活性分类和 pIC50 回归模型,并用随机划分和骨架划分测试。比较简单基线和模型,报告测试指标、误差最大的分子和适用范围,用组图解释结果。
结果出来后,可以追问:
请把随机划分和骨架划分下测试集里预测误差最大的分子分别列出来。
读懂结果
| 任务 | 本节使用的数据 | 目标与评价 |
|---|---|---|
| 化学多样性与分类 | 与第二节相同的 4,635 个预筛选分子 | pIC50 ≥ 6.3 为活性;用留出数据上的混淆计数、ROC 和 AP 等评价。 |
| 连续活性回归 | 原教程回归练习中的 3,906 个分子 | 预测 pIC50;用 MAE、RMSE 和 R² 等评价。 |
| 对未标注分子的预测 | T022 的另一个 60 行 test.csv |
可以输出预测,缺少实验标签时不能计算准确度。 |
1. 这一节做的是哪两种预测?
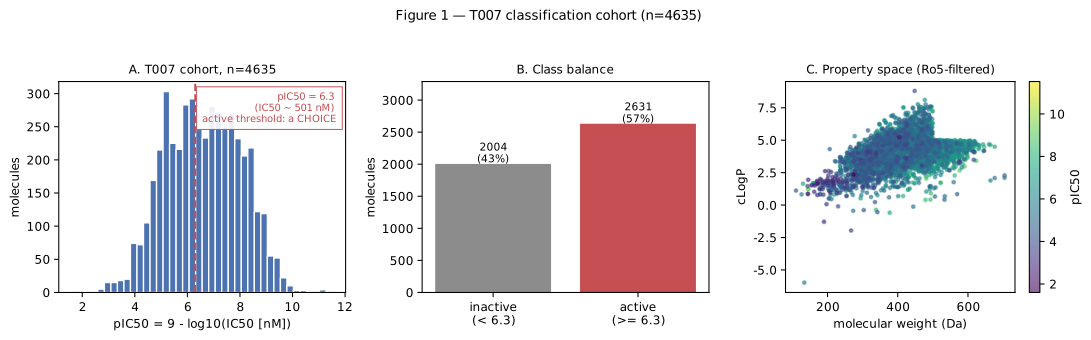
图 1|A 是 pIC50 分布与人为阈值;B 是两类样本数;C 是性质与活性。回归使用另一队列,样本数以回归表为准。
- 这张图看什么: A 是 pIC50 分布与人为阈值,B 是两类样本数,C 是性质与活性。
- 看到什么: 分类队列有 2,631 个活性、2,004 个非活性分子;pIC50 ≥ 6.3(约 501 nM)是本次教学界线。
补充说明
这条教学界线用于本案例;回归使用另一队列,样本数以回归表为准。模型同时与简单基线和多项指标比较。2. 分子聚成了哪些系列?
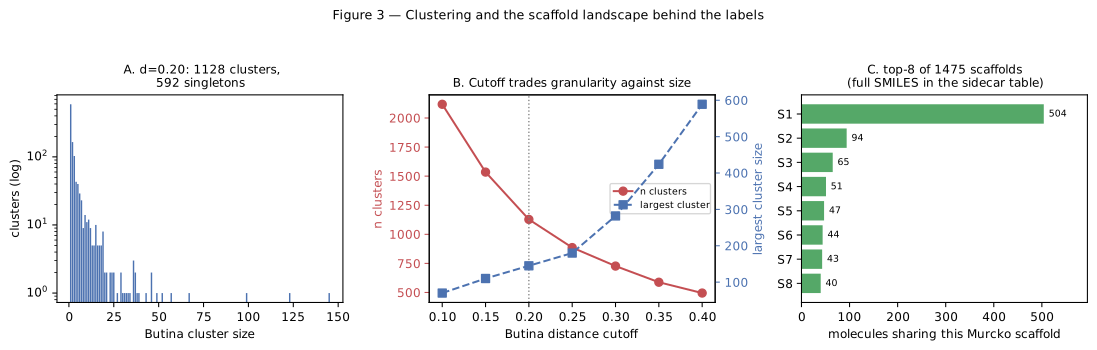
图 2|A 纵轴为对数刻度;B 同时展示簇数与最大簇大小,两个纵轴需分别阅读;C 用 S1—S8 对应不同骨架。
- 这张图看什么: A 纵轴为对数刻度;B 同时展示簇数与最大簇大小,两个纵轴需分别阅读;C 用 S1—S8 对应不同骨架。
- 看到什么: 4,635 个分子按 RDKit 路径指纹、Butina 距离阈值 0.20 分成 1,128 个簇,其中 592 个单分子簇,最大簇 145 个分子。换成 Murcko 骨架视角(保留环系及连接环系的链),得到 1,475 类骨架,最大一类 504 个分子,前五类共 761 个、占 16.4%。
补充说明
聚类和骨架分组回答不同的问题;读 B 面板时两个纵轴也需分别阅读。3. 结构相近,活性也相近吗?
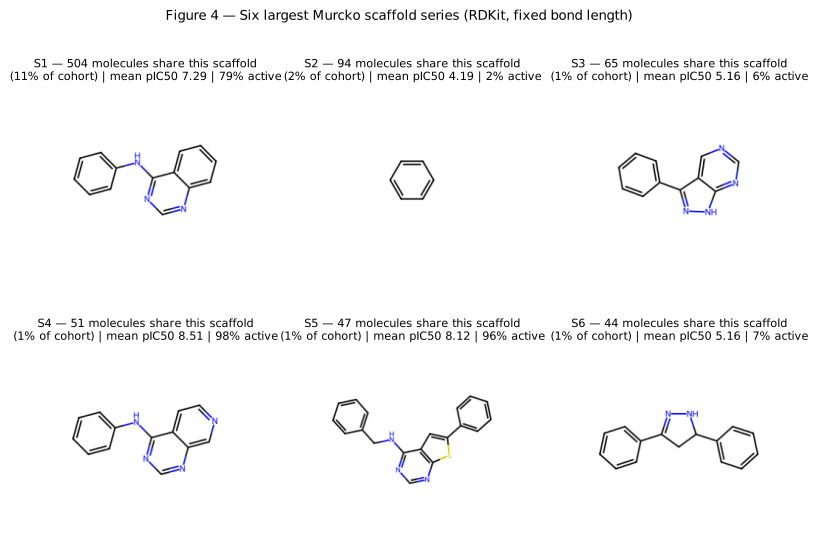
图 3|S1—S6 按系列大小排序,不按活性;每格计数表示共享该骨架的分子数,不表示分子完全相同。
- 这张图看什么: S1—S6 按系列大小排序,不按活性;每格计数表示共享该骨架的分子数。
- 看到什么: 在最近邻 Morgan 相似度 ≥ 0.7 的 3,887 个分子中,808 个与近邻相差至少一个 pIC50 单位,即 IC50 相差至少十倍。
补充说明
骨架相同不等于分子相同,也不保证活性接近;每格计数不表示分子完全相同。这是逐分子的近邻统计,同一对可能双向计入;不能改写成 808 对独立分子对,也不是模型的测试错误率。4. 分类曲线怎么读?
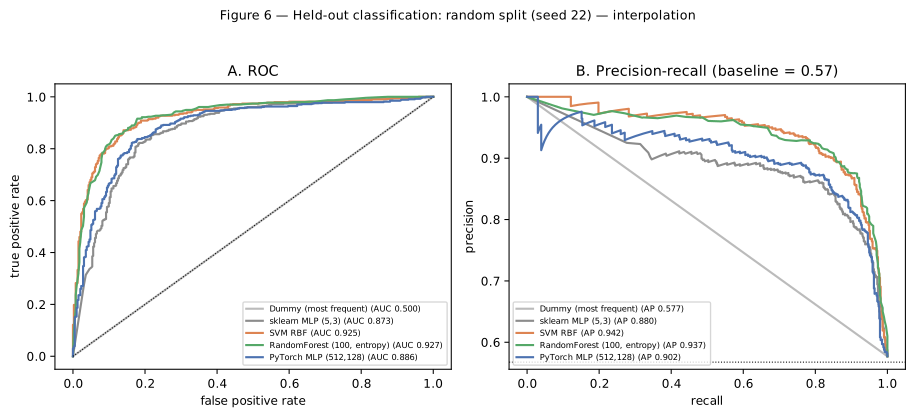
图 4|A 的 ROC 对角线为随机排序参考,对应 AUC 为 0.5;B 的虚线约为 0.577,与测试集活性比例有关;图例中 AP 是 average precision。
- 这张图看什么: A 的 ROC 对角线为随机排序参考,对应 AUC 为 0.5;B 的虚线约为 0.577,与测试集活性比例有关;图例中 AP 是 average precision。ROC 越靠左上角越好;精确率表示预测阳性中有多少真正阳性,召回率表示真正阳性中找回多少。
- 看到什么: 本图按 80/20 随机划分训练集和测试集,测试集中 705/927 个分子的骨架在训练集出现过。
补充说明
这种划分更多检验已见系列的新成员,不能直接代表全新化学空间。5. 换一种划分,模型还管用吗?
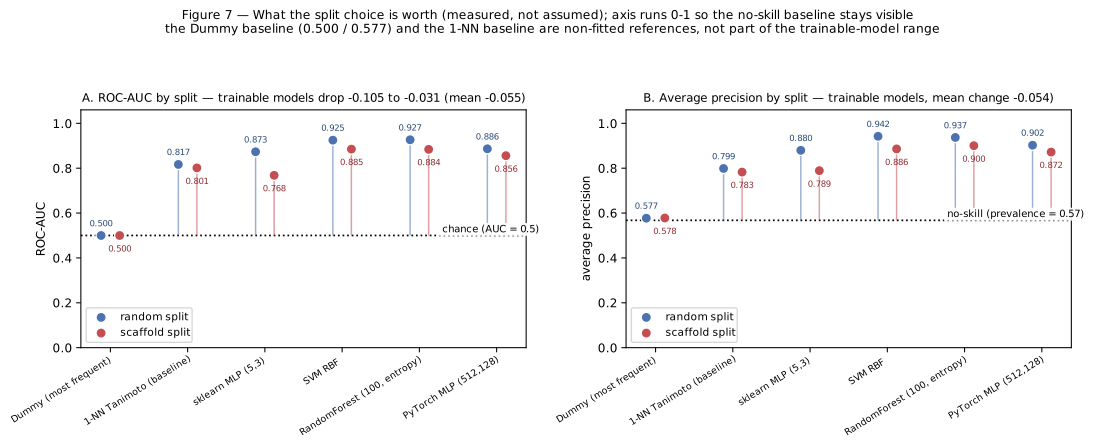
图 5|蓝点随机划分、红点骨架划分;A 是 ROC-AUC,B 是 AP。标题中的变化范围与均值只统计四个可训练模型。
- 这张图看什么: 蓝点随机划分、红点骨架划分;A 是 ROC-AUC,B 是 AP。标题中的变化范围与均值只统计四个可训练模型。
- 看到什么: 骨架划分的测试集有 782 个分子,与训练集无共享骨架。随机森林的 ROC-AUC 从 0.927 降到 0.884,SVM 从 0.925 降到 0.885,本次仍有排序能力。网络用训练内部的验证集选择权重,测试集不参与。
补充说明
两组测试成员和大小不同,不是只改变一个条件的因果实验;不同骨架仍可能共享局部结构。单次划分也不足以证明某类模型普遍更好。6. 回归预测的误差有多大?
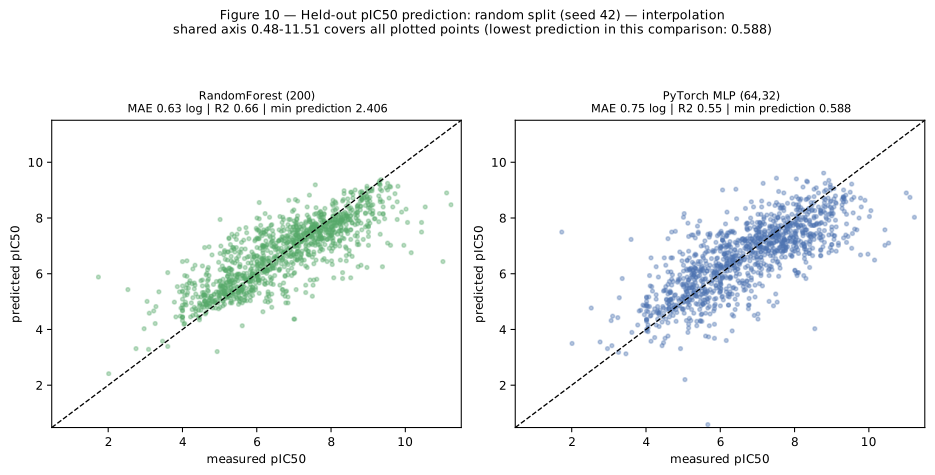
图 6|A 随机森林、B 神经网络;横轴实测 pIC50,纵轴预测,对角线表示二者相等,保留最低预测点。
- 这张图看什么: A 随机森林、B 神经网络;横轴实测 pIC50,纵轴预测,对角线表示二者相等,保留最低预测点;离线较远的分子值得单独检查。
- 看到什么: 回归使用另一份 3,906 分子队列,结果如下:
| 模型 | 随机划分 MAE | 骨架划分 MAE | 随机划分 R² | 骨架划分 R² |
|---|---|---|---|---|
| 训练集均值基线 | 1.247 | 1.258 | −0.001 | −0.007 |
| 最近邻基线 | 0.682 | 0.863 | 0.576 | 0.348 |
| 随机森林(Morgan) | 0.633 | 0.744 | 0.662 | 0.547 |
| 神经网络(64、32) | 0.749 | 0.909 | 0.552 | 0.356 |
MAE 是平均绝对误差,越小越好;R² 是相对测试集均值预测的表现,也可能为负。随机与骨架测试集分别有 1,172 和 1,074 个分子。
补充说明
这些数字不能与分类任务混用。本次用 PyTorch 重建原教程的两层网络,数值结果可能不同。7. 误差、训练过程和数据问题怎么放在一起看?
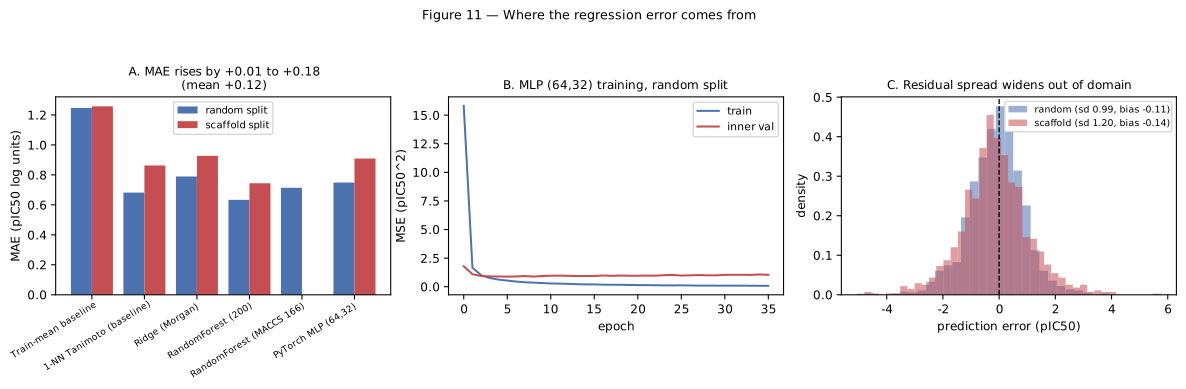
图 7|A 比较 MAE;B 是训练与验证损失;C 比较两种测试集上的误差分布。
- 这张图看什么: A 比较 MAE;B 是训练与验证损失;C 比较两种测试集上的误差分布。
- 看到什么: 随机森林的随机划分 MAE 为 0.633,最近邻基线为 0.682,均值基线为 1.247。简单近邻已提供不少信息,复杂模型需要证明额外收益。MACCS 随机森林未运行骨架划分,缺柱不是零误差。原表另有 47 行单位不是 nM,原数据保留作对照,nM-only 子集另作观察。
补充说明
训练误差下降不保证验证误差同步改善。MAE/RMSE 的单位是 pIC50,不能把平均对数误差解释为每个分子的固定浓度倍数差。8. 对新分子,模型什么时候不可靠?
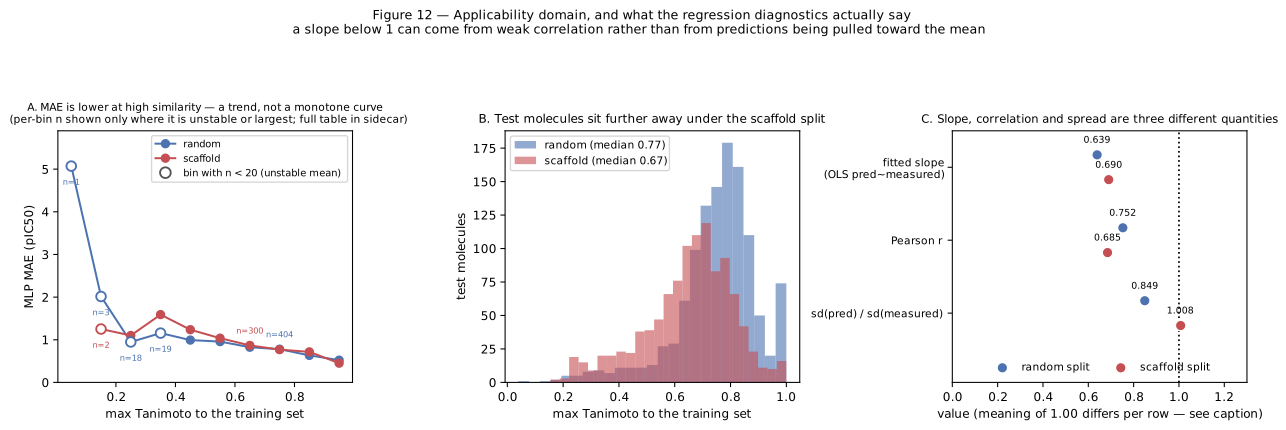
图 8|A 按最大相似度分箱展示 MAE;B 是两种划分的测试相似度;C 把三种散布诊断分开。完整分箱人数见旁表。
- 这张图看什么: A 按最大相似度分箱展示 MAE;B 是两种划分的测试相似度;C 把三种散布诊断分开;完整分箱人数见旁表。
- 看到什么: 按与训练集的最大相似度分箱观察误差:样本少于 20 的箱用空心点标记。另有 60 个无实验标签的分子,其中 26 个最大相似度低于 0.4。
补充说明
样本少于 20 的箱均值不稳,曲线也不是单调直线。0.4 这个阈值仅作教学提示,未经过独立验证;没有标签就不能算准确度。模型分歧或近邻相似度也不能自动当作校准过的预测区间。下一步
本节得到的是候选排序和后续研究的参考。继续第四节:蛋白上有很多凹陷,哪个口袋值得研究?:活性预测与结构证据相互补充,也各自保留自己的限制。去之前可以先发一句追问,把适用范围问清楚:
对那 26 个最大相似度低于 0.4 的无标签分子,能给出预测并说明适用范围吗?
下载第三节结果包,解压后先打开 readable-report.html。
| 想核对什么 | 打开哪个文件 |
|---|---|
| 输入与来源 | inputs/input_manifest.json |
| 聚类和骨架的具体成员 | results/butina_cluster_membership.csv、results/scaffold_series.csv |
| 训练、验证和测试分子 | results/classification_split_ids.csv、results/regression_split_ids.csv |
| 每个测试分子的预测 | results/classification_predictions.csv、results/regression_predictions.csv |
| 各图的实际绘图数据 | figures/ 下相应的子图 CSV 旁表 |
| 网络权重与学习曲线 | models/、results/*learning_curves.csv |
| 重新运行或仅重绘 | README.md 与 code/ |
原始教学内容:T005、T007、T022。原项目作者、论文和许可见指南首页。
返回指南首页。