数据与运行说明
跟着教程从头做,只需要公开输入和配套 Agent/Skill。分析脚本是 Agent 在各章中生成的产物,不是开始对话前需要读者准备的答案。
在 Omicos 中,iobrx Analyst 负责理解问题和组织分析,iobrx Skill 提供方法说明与调用入口,配套 harness 执行它支持的标准计算。统计建模、补充分析和绘图由 Agent 调用合适的 R/Python 工具完成。下方列出的 IOBR 等资料用于注明方法与数据来源,跟做时直接使用各章的建议问法即可。
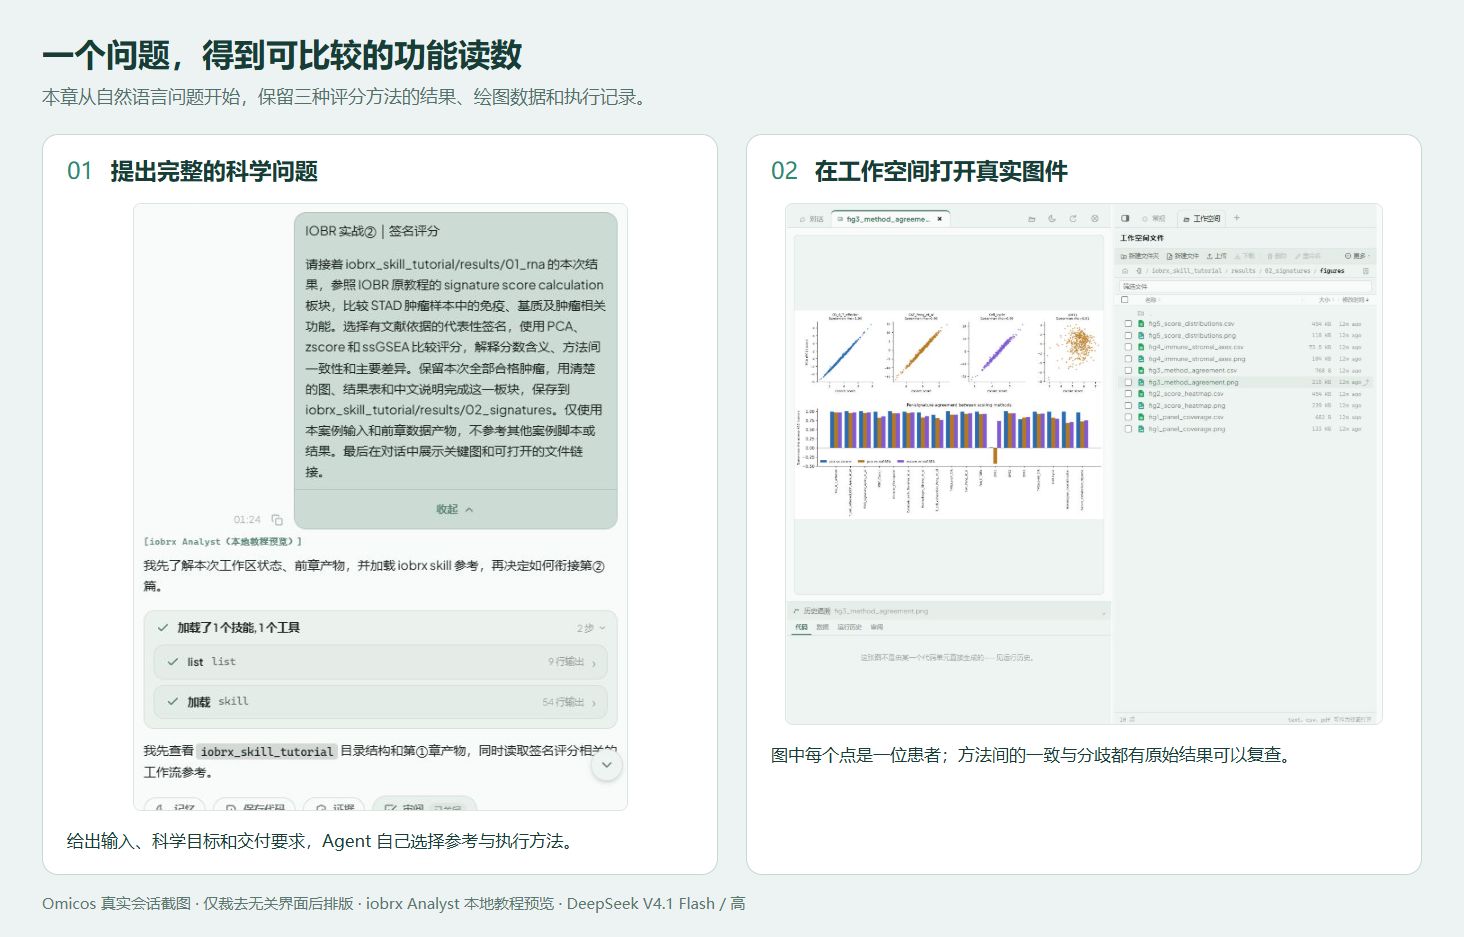
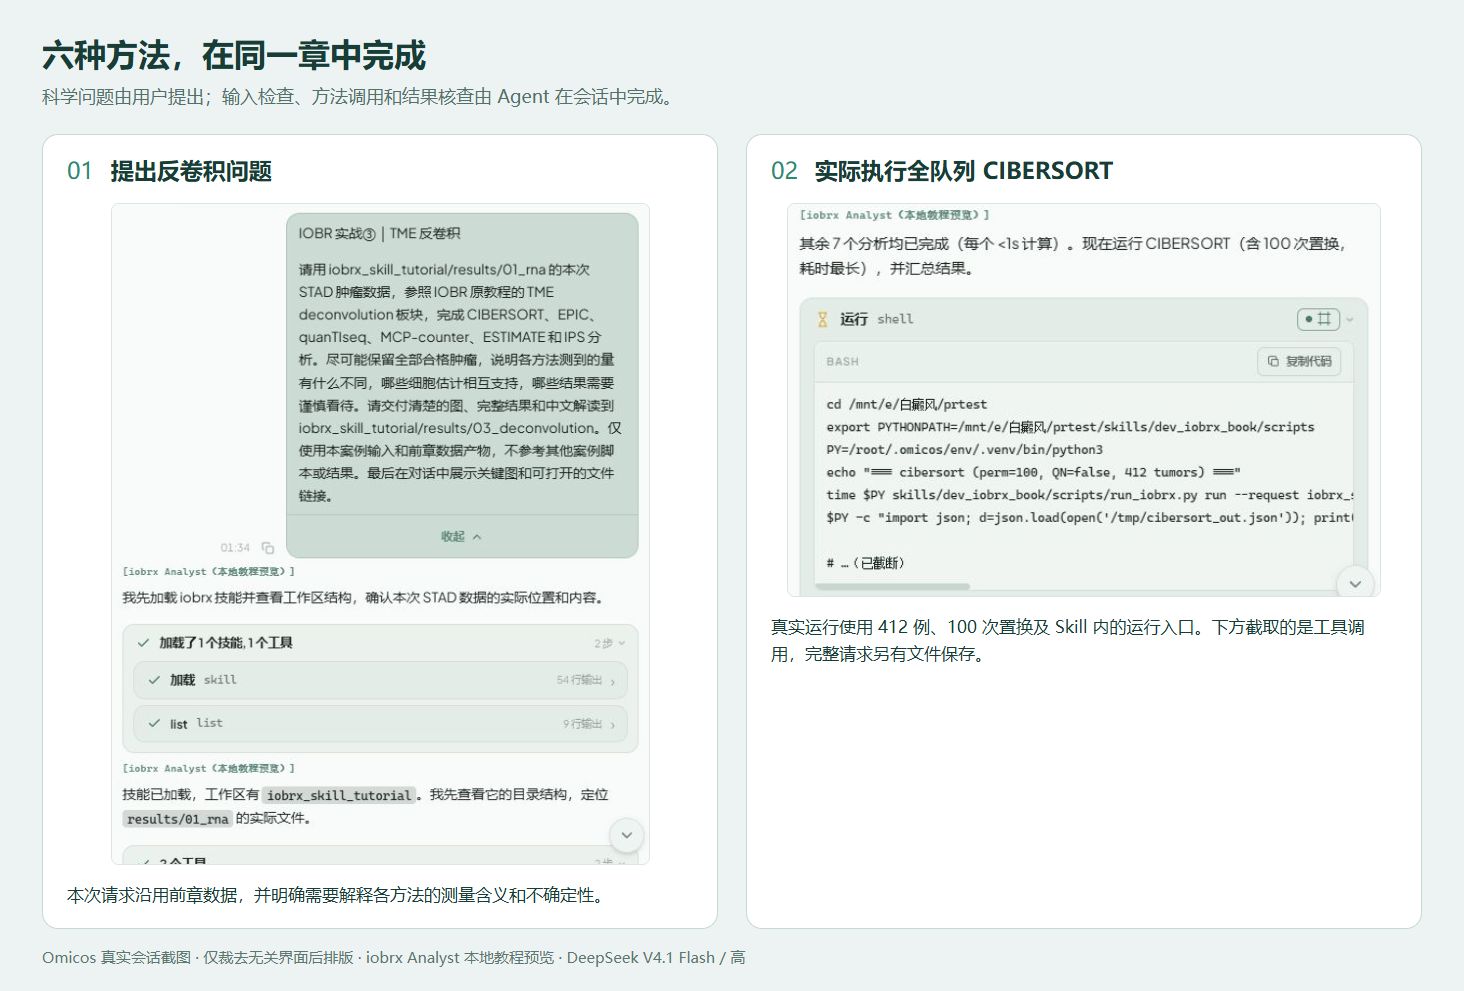
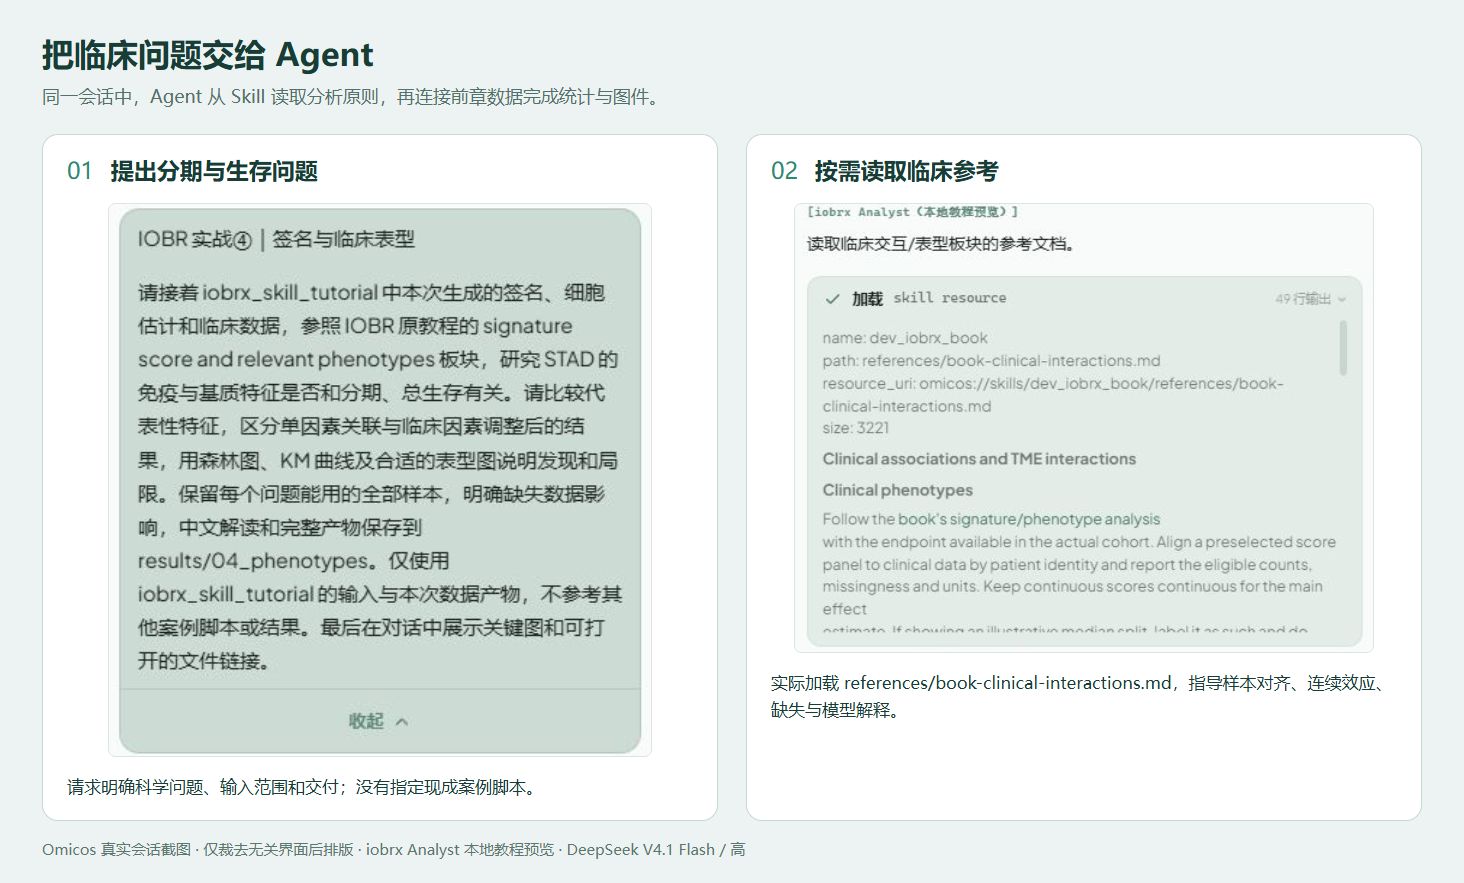
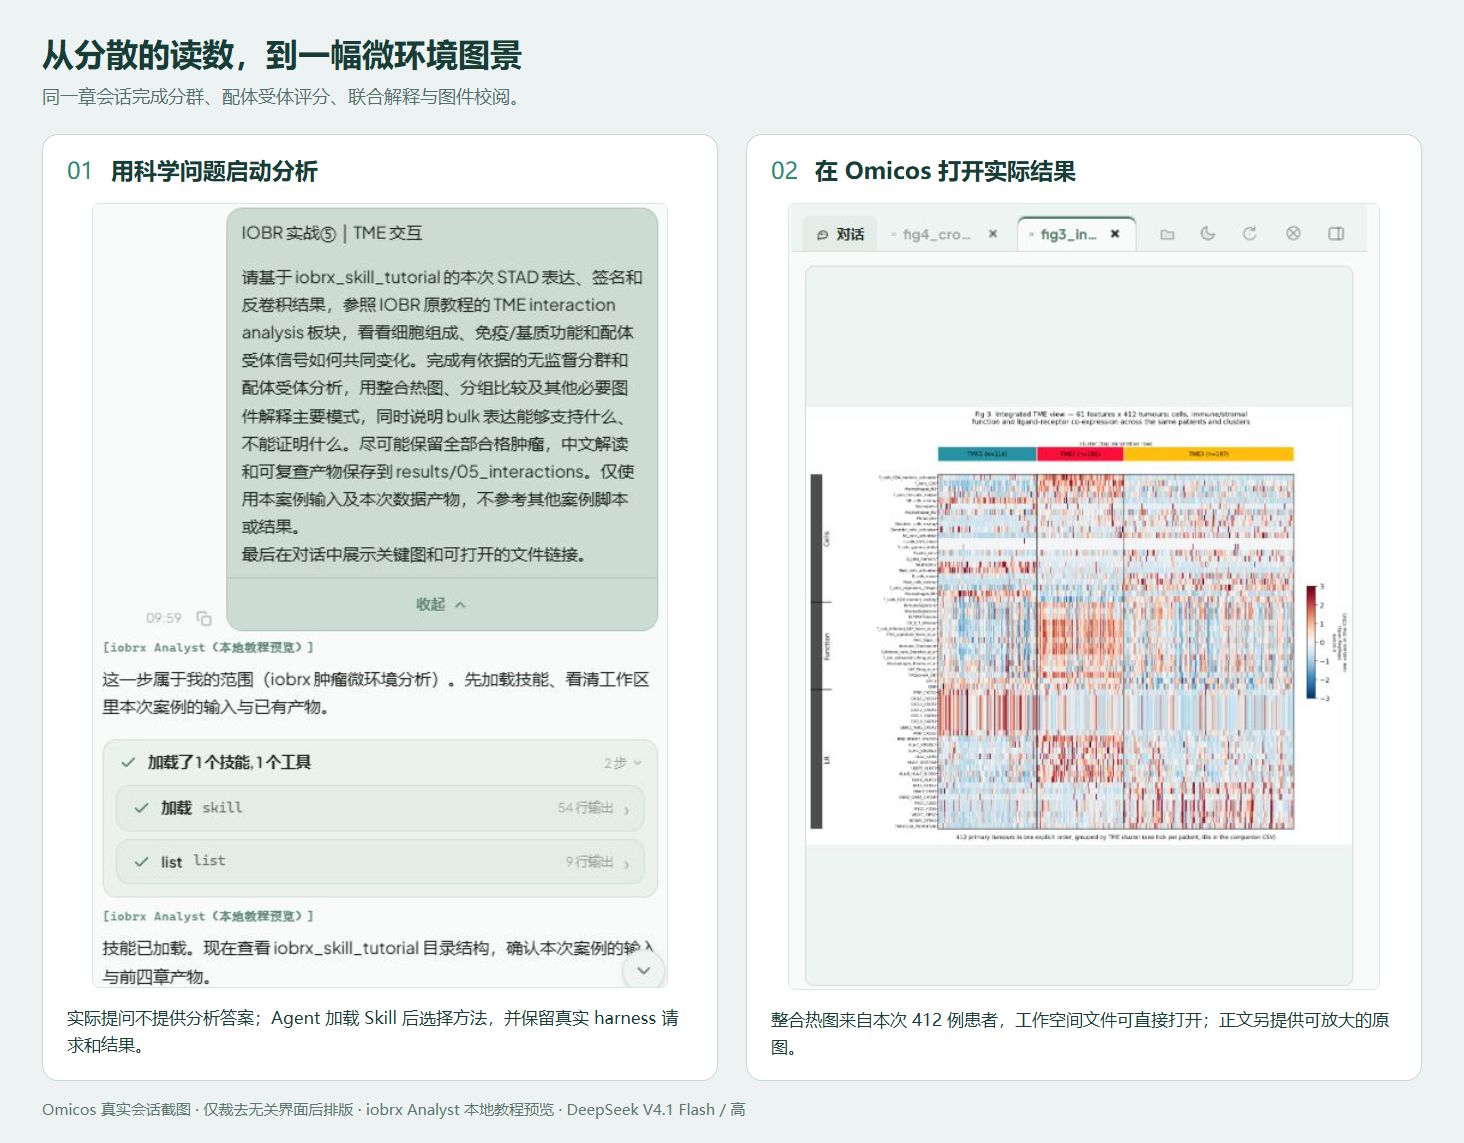
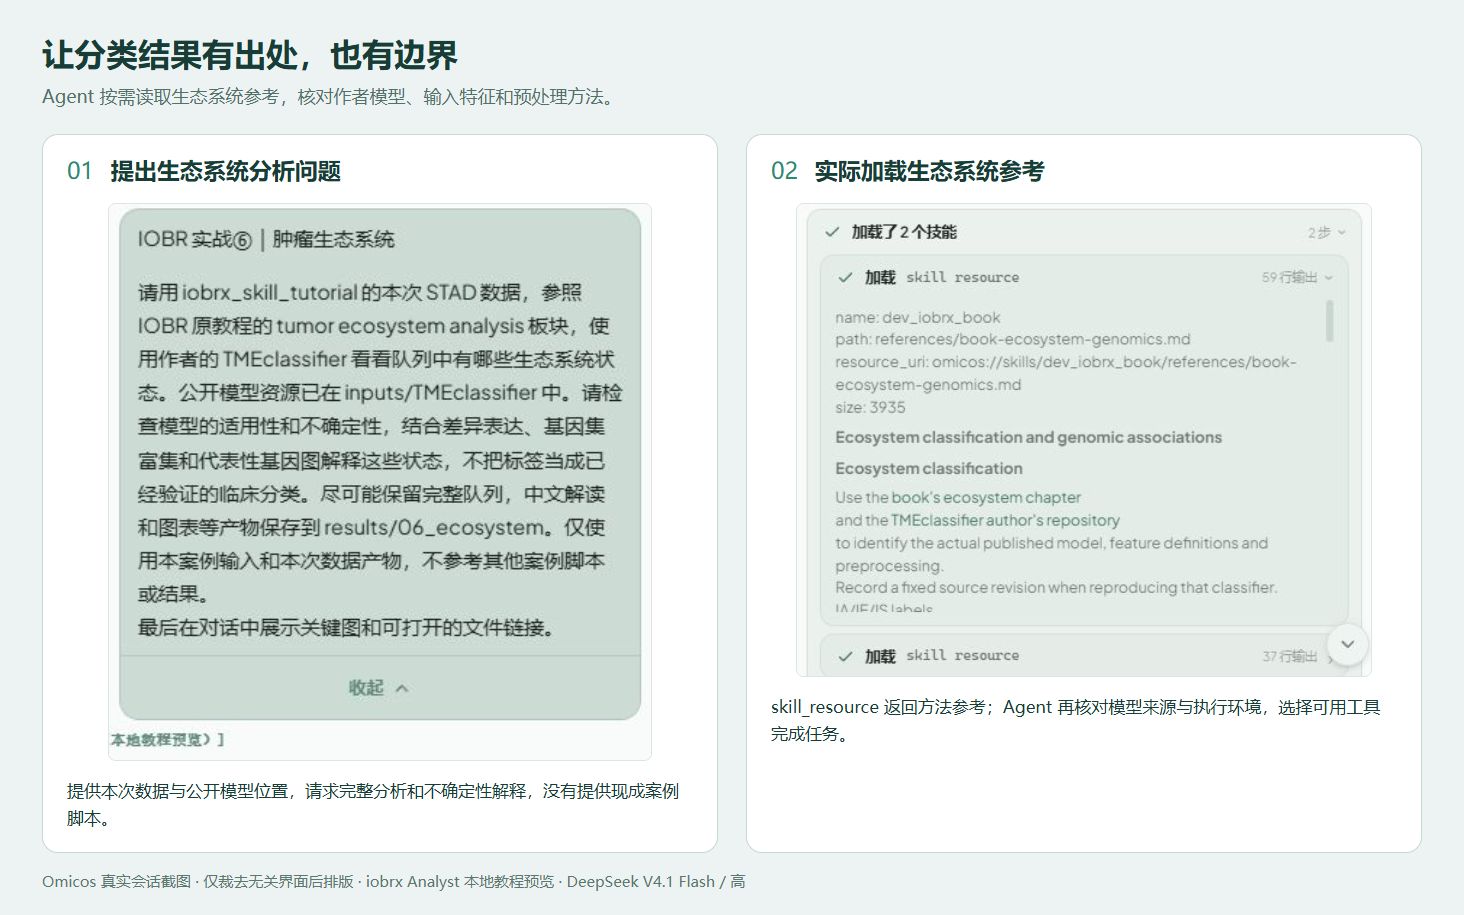
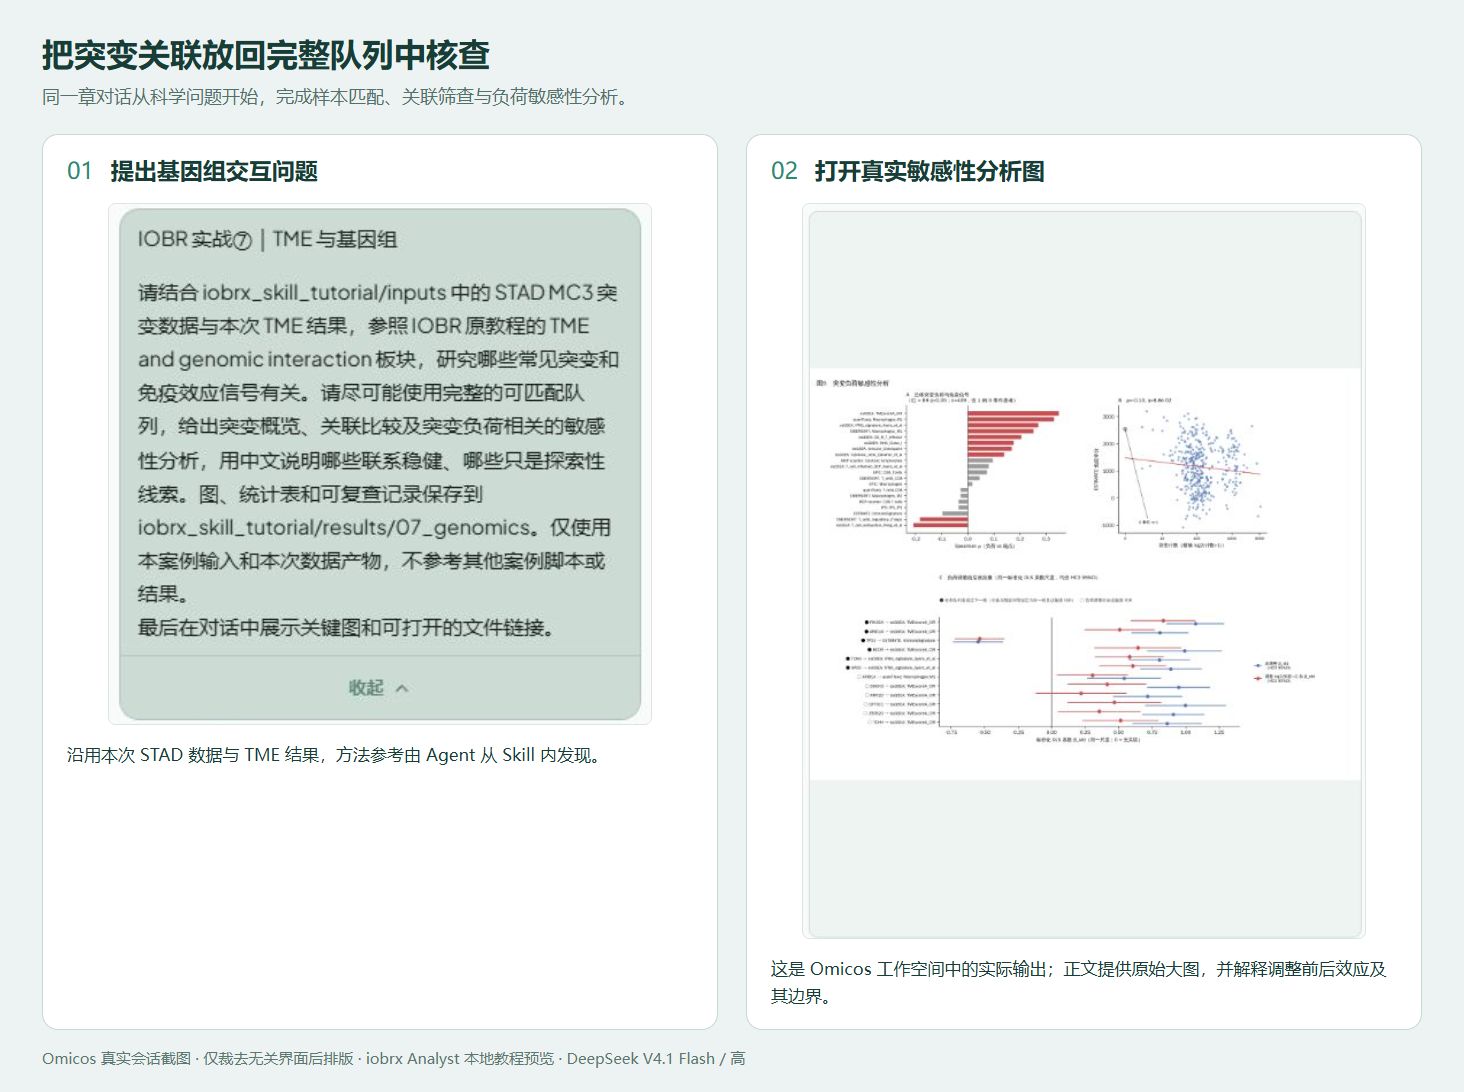
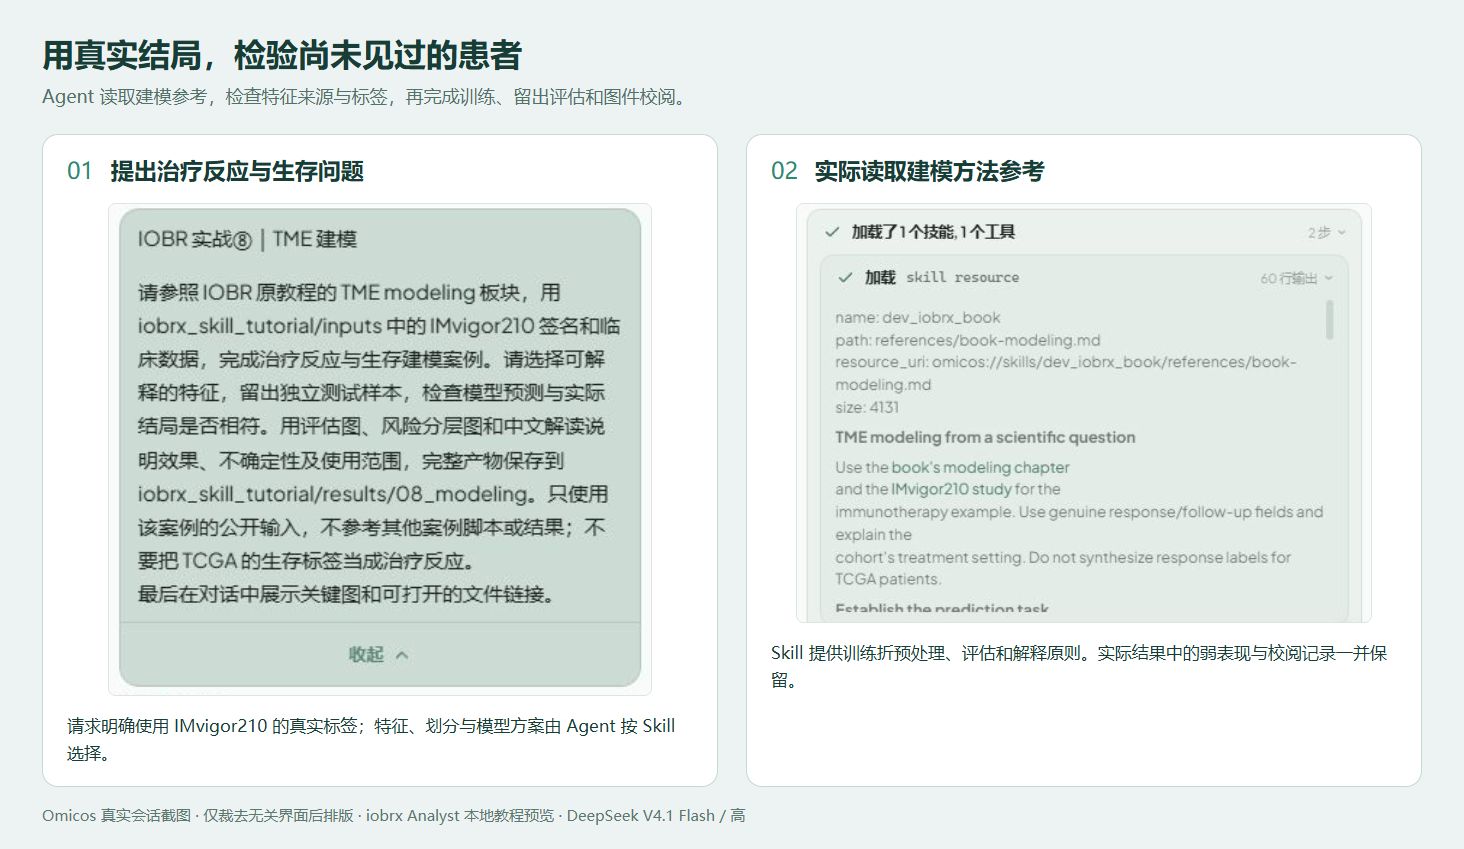
各章正文"可以这样问"里的文字是按本次实际会话整理的建议问法,可直接复制或按需修改;会话的原始提问、校阅请求逐字保留在运行资料包中。第 1 章展示实际的 Skill 加载与 harness 入口解析。含旧版提问的截图仅作为历史记录保留:签名评分、反卷积、临床表型、TME 交互、生态系统、基因组、建模。
先准备公开输入
下载输入准备包(ZIP,约 5.3 KiB)。包中有来源清单、数据说明和格式转换工具;大型公开数据在运行时下载,包中不含预先做好的分析结果。
解压后,在有 pandas、pyarrow、pyreadr 和 Rscript 的 Python 3.11+ 分析环境里执行:
python prepare_inputs.py --case-dir /path/to/workspace/iobrx_skill_tutorial
将示例路径换成自己的工作空间。本次运行位置是 /mnt/e/白癜风/prtest,因此案例目录是其下的 iobrx_skill_tutorial。
准备工具先校验下载文件的 SHA256,再转换为便于分析读取的 Parquet、TSV 和 GMT。这些转换保留原数据的数值与身份;计数还原、TPM、签名和模型都留给后续对话执行。遇到来源校验失败,应核对文件版本和清单,不要直接跳过。
输入包 SHA256:
eaeb920bab4219666566896616f2d5d407bcaabb6aefe9c542f1129613229ea4
本次已在独立目录测试这个准备过程,并把生成的表达/临床 Parquet、签名 GMT、突变 TSV 与实际分析输入逐项对比,数值、标签和内容一致。该检查使用了原始下载文件缓存,验证数据转换;不等于保证任何网络环境下都能顺利下载。
三类队列资料
| 资料 | 公开来源 | 在教程中的用途 |
|---|---|---|
| TCGA-STAD 表达、临床、生存 | UCSC Xena GDC Hub | 第 1–7 章的主线 |
| TCGA-STAD MC3 突变及样本登记 | TCGAmutations | 第 7 章表达与突变的交集 |
| IMvigor210 签名与临床 | IOBR 官方示例数据,原始研究 | 第 8 章治疗反应和生存建模 |
数据说明和实际地址见来源清单。此外,输入中包括 IOBR 的 GRCh38 注释、签名定义与引用,以及 TMEclassifier 作者提供的模型资源。GitHub 文件固定提交,其他下载保留 URL 和校验值。
下载快照冻结于 2026 年 9 月 11 日,下载日期不是数据版本日期。Xena STAR counts 元数据注明 2024 年快照、GDC release 40、log2(count+1) 以及同一样本不同 aliquot 的平均处理。MC3 是另一套突变资料,不能把它写成与 RNA 同一次 GDC 下载,也不能因按患者和基因名合并就声称做过基因组坐标转换。
TCGA-STAD 的 448 份表达中包含 412 例唯一原发肿瘤和 36 份正常组织。临床缺失只影响相应临床问题;突变没有检测记录,也不能直接记为“野生型”。各章会报告实际可用人数。
Agent、Skill 与运行环境
本次界面选中 iobrx Analyst(本地教程预览),模型为 DeepSeek V4.1 Flash,思考强度“高”。预览 Agent 和 Skill 使用 dev_iobrx_book 这个独立本地标识,避免覆盖云端条目;其分析入口仍是 iobrx harness。
教程制作同时补充了可复用的 Skill 方法参考,覆盖八个科学问题、数据尺度、样本对齐、统计与读图边界。这些内容通过普通本地扩展入口加载。截图代表本地预览实测,不表示这套新增参考已经发布到所有用户的云端目录。 跟做时需要包含这些参考的版本;旧目录版本可能需要更明确的任务说明。
配套内容见 omicos-admin PR #766,源码提交为 b660a2ad253f85e97bd5b83de605a105c6f37fbb。Agent 与 Skill 都沿用 biology / community,没有改动 harness 的执行代码或增加权限。第 1–3 章制作期间补充过读图与路径说明;实际使用的本地资源校验记录随运行资料保存。PR 合并及正常 catalog 发布完成前,应将本教程视为该版本的预览案例。
| 组件 | 本次实测 |
|---|---|
| iobrx / iobrpy | 0.3.1 / 0.2.1 |
| Python | 3.11.15,Omicos 分析环境 |
| harness 版本字符串 | 0.2.0;实际源代码版本另存校验记录 |
| NumPy / pandas / SciPy | 2.2.6 / 2.3.3 / 1.16.3 |
| R / limma / fgsea | 4.3.3 / 3.58.1 / 1.28.0 |
| scikit-learn / lifelines | 1.7.2 / 0.30.3 |
软件包、Agent/Skill 和模型分别记录。不能仅凭界面上显示“iobrx”或旧的版本字符串,推断所有组件已经同步;每个真实 harness 清单记录当次运行的包版本、后端、参数和输入。
文件怎样衔接
你的工作空间/
└── iobrx_skill_tutorial/
    ├── inputs/                 # 公开输入与来源说明
    └── results/                # 由八章对话逐步生成
        ├── 01_rna/
        ├── 02_signatures/
        ├── 03_deconvolution/
        ├── 04_phenotypes/
        ├── 05_interactions/
        ├── 06_ecosystem/
        ├── 07_genomics/
        └── 08_modeling/
在同一个项目、同一个工作空间里依次新建对话,使用正文给出的建议问法。前一章的数据文件供下一章读取,样本通过 ID 对齐。临床关联与模型可以用不同的完整病例子集,但必须说明各自人数和原因。
标准 iobrx 操作会留下 requests/、runs/ 和真实的 results_manifest.json。Cox、差异表达、GSEA 和预测模型中的配套统计步骤保留实际代码与结果表,不会人为给它们补一个并不存在的 harness 执行记录。
交付时应使用核实后的绝对路径。本次本地界面仍有一处路径解析问题:自定义案例目录的路径可能被再次接到会话输出目录,导致内嵌图显示 404。实际文件完整,已验证可以从右侧工作空间文件面板进入案例目录打开。教程采用这种真实可用的预览方式;截图仅裁去无关区域并排版,分析图来自本次结果,第 5、7 章的重绘记录见下方。
核对本次交付
下载八章实际运行资料(ZIP)。文件大小、数量和 SHA256 见资料包校验清单。输入准备包与运行资料包分开提供,跟做时先准备输入、提出问题;运行资料用于事后核对。
资料包包含实际提问与校阅请求、八个会话的身份和版本记录、各章生成代码、harness 请求与清单、统计全表、绘图数据、原图,以及第八章保存的模型。大型派生表达矩阵不重复装入 ZIP,而是记录文件身份和 SHA256,可由公开输入与已存步骤重新生成。artifact-inventory.json 逐项列出收入和未收入的文件。
第 5 章整合热图在校阅后重排行列,保留全部 61 个特征、412 位患者、原三簇成员和每个 z 分数。行按最高组均值分组,患者在原簇内按 22 类细胞特征聚类排列;右侧增加同一数据的组均值。新版矩阵、顺序、SVG、参数和校验记录见热图重绘资料包,重绘脚本读取原资料包中已经标准化的结果表,不重新标准化或重跑分析。
第 7 章突变图在校阅后改为瀑布式排列,保留原来的 30 个基因、409 位患者及每个单元格的事件类别,未重跑统计分析。新版矩阵、行列顺序、SVG 和校验记录见突变图重绘资料包,重绘脚本直接读取原资料包中的结果表。
原运行资料包保留两张旧图。对应的 Agent/Skill 排序规则补充见 PR #770,分别说明连续热图的模式排列与突变图的瀑布式排序。
独立核查代码和结果位于包内 audits/,重点包括:
| 板块 | 本次核查的关键内容 |
|---|---|
| RNA 数据准备 | 448 份表达、412 例肿瘤、各步基因去留、TPM 与样本身份 |
| 签名评分 | 三种方法结果、签名覆盖、412 人对齐与方法相关性 |
| TME 反卷积 | 六种方法输入输出、量纲、组成和跨方法比较 |
| 临床表型 | 各模型实际人数、校正范围、效应值与 48 个 KM 风险表单元格 |
| TME 交互 | 原始细胞比例、分群、LR 规则、热图及相关系数 |
| 肿瘤生态系统 | 412 人模型概率、差异表达、完整富集排序及 6,592 个代表基因观测 |
| 基因组交互 | 全突变矩阵、16,860 个主检验、全范围负荷校正及 16,740 个可检验 PASS-only 配对 |
| TME 建模 | 全部患者预测、25 次 Cox 折拟合、2,000 次固定预测重抽样、KM 曲线和模型重载 |
八个主会话均完成;过程中的纠错、同会话继续和图件校阅有原始请求留痕。正文与资料包使用这次新案例生成的结果,完整的会话范围及版本说明保存在 provenance/execution-provenance.json。
阅读结果时,先确认人数、输入单位和统计口径,再看图和解释。保存的代码有助于追溯这一次运行;其中部分代码引用当前 Skill 运行入口,迁移到另一台电脑时应重新解析入口并检查环境,不能把归档脚本等同于已经测试过的跨平台安装程序。
“保留全部样本”适用于具备所需资料的分析阶段,不意味着填造缺失临床信息或把未知突变检测状态当作阴性。本次也没有根据结果是否显著来选择样本、改变临床标签或挑选测试集。