10 · 模型什么时候值得相信,什么时候该继续查证?
模型给出预测后,怎样判断它是否可靠?本节包含两个独立案例:EGFR(T037) 用来检查模型分歧与活性预测误差的关系;KIBA(T038) 用来学习蛋白与配体的联合建模。两组数据分别解读。
发什么提示词
新建对话,选择 CADD Workflow Runner。
发送:
请自行获取 EGFR 活性数据和 KIBA 公共数据,分别训练不确定性模型与蛋白–配体相互作用模型。报告测试误差、区间覆盖、模型分歧和分类表现,说明哪些结果可以指导下一步研究,并把两组案例分开解读。请从公开数据开始,不依赖预置脚本或本地教程输入。
结果出来后,可以追问:
请按原始行号列出误差最大的测试样本,看看模型分歧是否也更大。
读懂结果
EGFR案例有2,701行原训练数据和1,158行测试数据。原训练池再分为2,159行拟合、542行校准,相同指纹放同一侧;原训练池与测试集仍共享37种指纹、涉及41行测试,不能称为严格的新结构测试。输入没有分子编号,本次保留原行号,不强行拼接其他章节的分子表。
1. 模型分歧能提示预测误差吗?
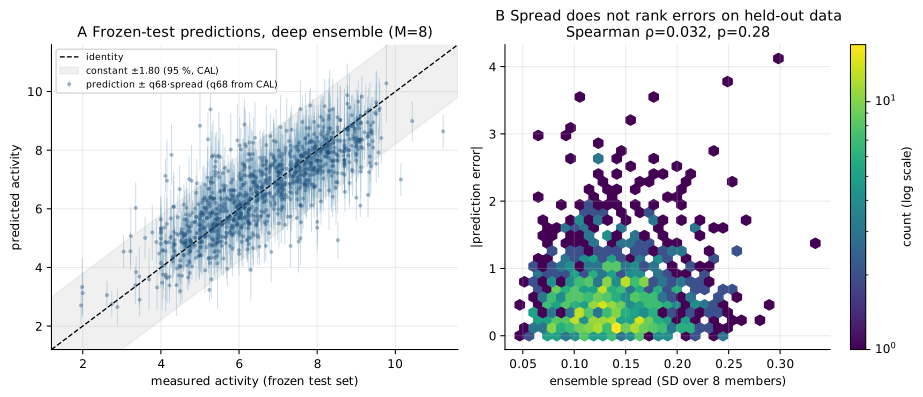
图 1|模型分歧能找出更容易出错的样本吗? 左:测试预测与两种预测区间(细线为校准后的 68% 区间,灰带为恒宽 95% 对照);右:成员分歧 vs 绝对误差,六边形密度用对数色阶。
- 这张图看什么: 左图看测试预测落在两种预测区间里的情况;右图看成员分歧与绝对误差的关系;下表比较几种训练方式的测试误差。
- 看到什么: 训练单网络、8 个独立初始化模型和6个重采样异构模型,每个20轮。集成取成员预测的平均,成员标准差表示分歧:
| 方法 | 测试 MAE | 测试 RMSE |
|---|---|---|
| 只预测拟合样本的平均活性 | 1.241 | 1.477 |
| 单个前馈网络 | 0.681 | 0.902 |
| 8 个独立模型的平均预测 | 0.661 | 0.882 |
| 6 个重采样异构模型的平均预测 | 0.711 | 0.938 |
独立集成在本次测试中误差略低,重采样集成没有进一步改善。分歧与绝对误差的 Spearman 相关(衡量两个排序是否同向的指标,接近 0 表示看不出关联)约 0.032,p≈0.28,未显示明显的单调关联。
补充说明
模型分歧与误差在本次测试中没有明显同步变化,判断可靠性还要结合测试误差和区间覆盖率。2. 预测区间实际覆盖了多少样本?
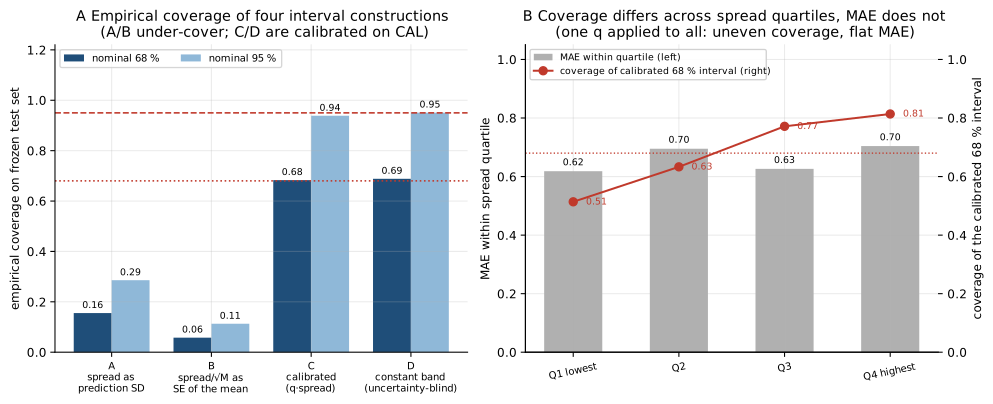
图 2|先检验区间的含义。 A:四种区间构造的实际覆盖率;B:按分歧大小分四组后的平均误差与校准区间覆盖率。
- 这张图看什么: A 看四种区间构造各自的实际覆盖率,B 看按分歧大小分四组后的平均误差与校准区间覆盖率。
- 看到什么: 名义 95% 区间若直接用成员标准差构造,实际仅覆盖 28.6%;再除以 √8 后约 11.3%。用校准集残差调整后覆盖约 93.9%,忽略分歧的恒宽对照也有 95.1%。名义 68% 时,两者覆盖约 68.3%、68.8%,平均半宽约 0.840、0.780,总体覆盖接近目标。本次使用线性插值的经验分位数,只报告实测覆盖,也没有通过测试答案调整区间。
补充说明
直接用成员标准差构造的做法不能自动得到单个化合物活性的预测区间;总体覆盖接近目标,并不能证明逐样本的分歧估计有效;本次**没有给出新数据上严格的有限样本保证**。3. 误差还可能来自哪里?
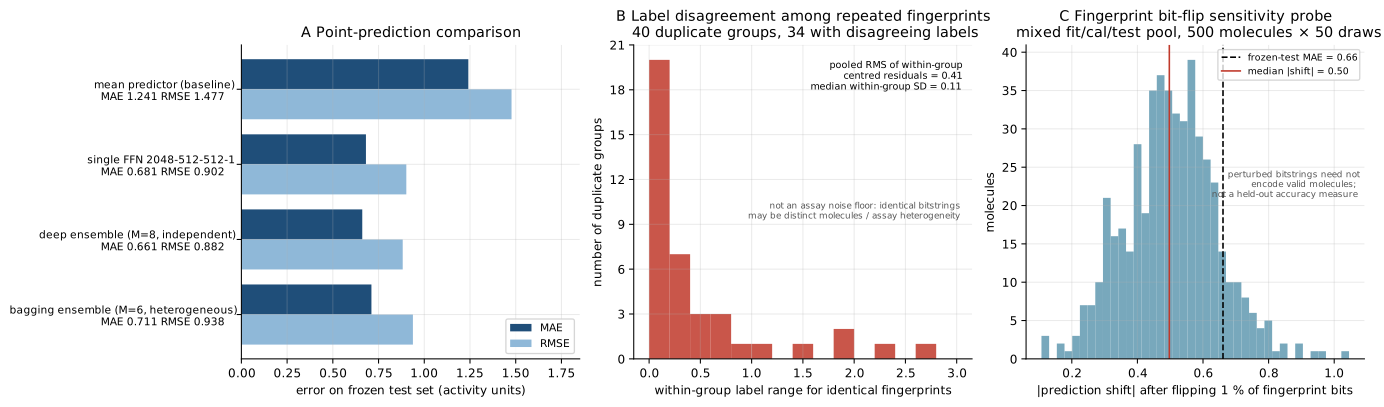
图 3|A:方法误差比较;B:重复指纹的标签差异;C:指纹位翻转后的预测变化。扰动后的位串未必对应有效分子。
- 这张图看什么: A 比较各方法误差,B 看重复指纹对应的标签差异,C 看指纹位翻转后预测变化多大。
- 看到什么: 原训练池的 40 组重复指纹中,34 组标签不完全一致;组内残差 RMS 约 0.41、中位组内标准差约 0.11,这是两个不同统计量。对 500 行指纹按 1% 概率翻转位、重复 50 次,预测均值的绝对变化中位数约 0.50:模型会受扰动影响。
补充说明
组内残差 RMS 与中位组内标准差都不能直接叫作实验噪声下限——相同指纹可能对应不同分子或不同实验条件;翻转后的新位串未必对应有效分子,这不是分子生成或另一份精度测试。4. KIBA 模型实际读入了什么?
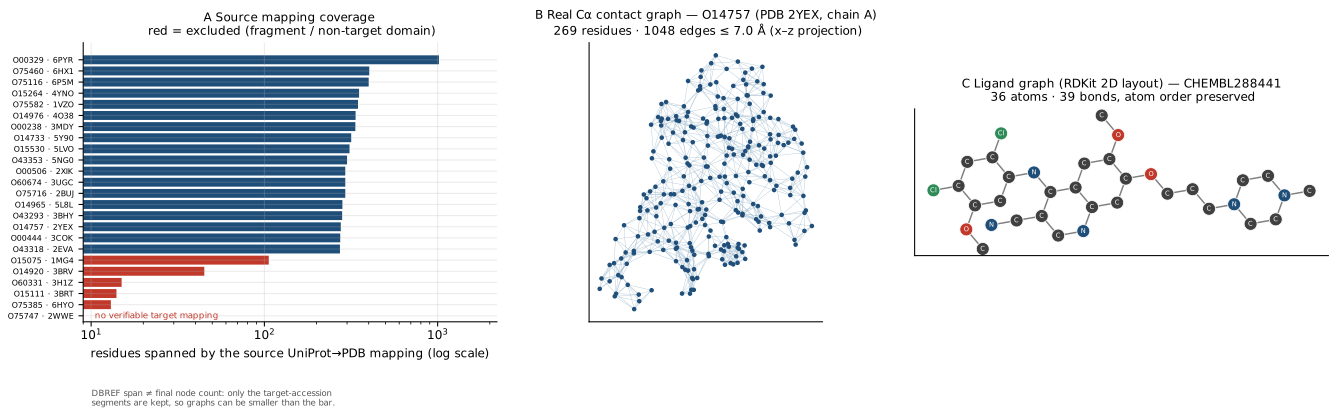
图 4|先确认模型读到了什么。 A:24 个原映射的覆盖记录,红色为排除项(映射跨度不等于最终图节点数,也不能仅凭长度判断结构域是否合适);B:CHK1(O14757、2YEX、A 链)真实 Cα 接触网络的 x–z 投影;C:CHEMBL288441 同一保存 SMILES 的二维原子图。
- 这张图看什么: A 看哪些原映射被保留、哪些被排除;B 看真实 Cα 接触网络的投影;C 看配体的二维原子图。
- 看到什么: 分三组看——数据规模、图结构、结构筛选:
- 数据规模:KIBA 整合 IC50、Ki、Kd 等不同证据。本节沿用 T038 的特定表格变换:已观测值 < 3.6122 记为1,其余已观测值记为0。筛选得到 79 × 372 表格,含 28,843 个已测配对、545 个缺测位置。CPU 子集在看结果前固定,查询与结构核查后保留 76 个配体、18 个蛋白、1,329 个配对,其中标签1有340个。
- 图结构:配体图的节点是原子、边是化学键;蛋白图以 Cα 为节点,距离≤7 Å连边。图中 CHK1 有269个节点、1,048条边,CHEMBL288441 有36个原子、39条键。
- 结构筛选:结构不能只凭映射编号使用:3BRV与1MG4未包含所需激酶结构域而排除;2EVA仅取TAK1残基31–303的261个有坐标节点。
补充说明
KIBA 整合的不同证据定义与实验条件不同,不能直接互换;阈值不适用于其他版本,缺测与异常值不作阴性;接触边来自结构坐标,**不是注意力权重或结合机制归因**。5. 训练轮次是怎样选出来的?
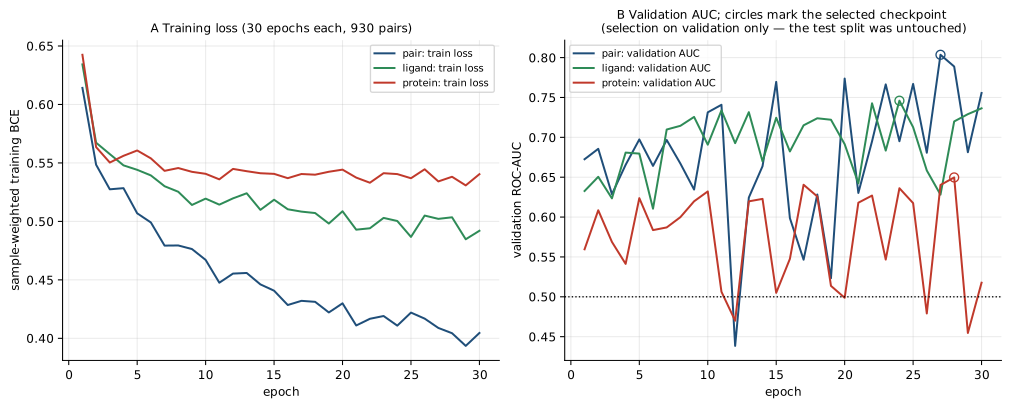
图 5|训练误差下降后,还要看验证数据。 左:训练损失;右:验证 AUC;空心圆为各模型实际保存的轮次(没有用最后一轮自动代表最佳模型)。
- 这张图看什么: 左看训练损失下降,右看验证 AUC;空心圆标出各模型实际保存的轮次。GIN 是一类直接读取图结构的神经网络。
- 看到什么: 1,329个配对划分为 930训练、265验证、134测试。双图、仅配体、仅蛋白模型各训练30轮,按验证AUC选择第27、24、28轮,测试集不参与选择。这是带边特征的GIN风格教学实现,与原教程的汇总方式等设置不同。模型联合读取两张图,未计算结合姿势。
补充说明
测试集的58个配体和18个蛋白都在训练集出现过,只检验未见配对,不能替代未见配体或靶点测试。6. 排序好,就等于固定阈值下分类好吗?
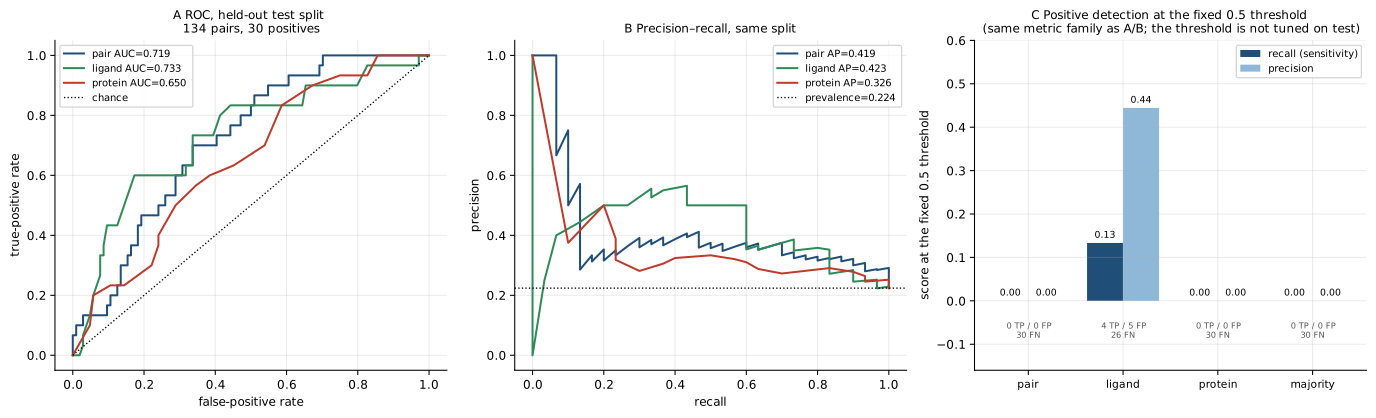
图 6|把分数排序与实际分类分开看。 A、B:ROC 与精确率–召回率曲线;C:0.5 阈值下的召回率、精确率与实际分类计数(未预测出标签 1 的方法精确率按 0 展示,这是显示约定)。
- 这张图看什么: A、B 的 ROC 与精确率–召回率曲线看排序能力,C 与下表看默认阈值下的实际分类。AUC评价排序,AP关注精确率–召回率;两者都要与基线比较。
- 看到什么: 同一测试集比较如下:
| 模型 | 选中的训练轮次 | 测试 AUC | 测试 AP | 0.5 阈值下检出的标签 1 |
|---|---|---|---|---|
| 蛋白与配体双图 | 27 | 0.719 | 0.419 | 0 / 30 |
| 仅配体 | 24 | 0.733 | 0.423 | 4 / 30 |
| 仅蛋白 | 28 | 0.650 | 0.326 | 0 / 30 |
| 始终预测训练集多数类 | 不训练 | 0.500 | 0.224 | 0 / 30 |
双图模型的AUC约0.719,但0.5阈值下没有检出标签1;“全部报0”也有77.6%的准确率。仅配体模型检出4/30,误报5个,精确率为4/9。
补充说明
本次未显示加入蛋白图改善测试表现。小规模、单种子结果不足以普遍排名模型;输出也未经过独立概率校准,不能解释为真实结合概率。下一步
十节的证据分别支持不同层面的判断,不会自动汇成一个“最佳药物”分数;更实用的交付是说明观察到了什么、什么值得进一步检验。可以先发一句追问,把本节两个案例收拢成一页:
本节 EGFR 与 KIBA 两个案例里,哪些结论已经可以支持下一步研究,哪些还需要继续查证?请按案例分别整理,并附上对应的数字与边界。
| 想回答的问题 | 本指南已经展示的证据 | 还需要怎样推进 |
|---|---|---|
| 数据是否适合开始分析? | 第01节的来源、单位和记录对应 | 核实自己数据的实验条件与测量定义 |
| 哪些分子值得优先查看? | 第03节的化学空间与留出误差 | 检查新分子是否超出模型适用范围 |
| 结合姿势是否合理? | 第05节的重对接与交互结构查看 | 用适当的结合或活性实验检验候选 |
| 怎样缩小候选范围? | 第06节的性质、对接与相互作用对照 | 明确筛选取舍,核实化学可用性 |
| 结构会怎样随时间变化? | 第07节的真实短轨迹 | 用足够采样和重复研究具体动态问题 |
| 是否可能影响其他靶点? | 第08节的多角度激酶比较 | 用相应靶点面板检验选择性假设 |
| 预测为什么改变? | 第09节的表示和几何变换检验 | 区分模型行为、数据分布与实际化学机制 |
下载本节完整结果包,解压后先打开 readable-report.html。
| 想检查什么 | 打开哪个文件 |
|---|---|
| 本节各项结果与结论怎样串起来 | readable-report.html |
原始教学内容:T037、T038。不确定性方法可进一步阅读 Scalia 等,2020。药物与蛋白联合建模可参考原教程引用的 GraphDTA 论文:它使用配体图和蛋白序列进行亲和力回归;本节 T038 使用双图分类,输入和任务不同。
文献与结构记录:Tang 等,2014、3BRV、1MG4、2EVA。
返回指南首页。