2. 签名评分:把一组基因读成一种功能
本章沿用第 1 章准备的 412 例 TCGA-STAD 原发肿瘤 RNA-seq 数据。
这一步想知道什么
第 1 章留下五万多个基因的表达,直接读不动。把一组相关基因当作一个"签名"(signature)、为每份样本算一个概括分数,就能比较患者之间的免疫、基质等功能信号。本章还想弄清:这个分数到底代表什么,三种算法会不会给出不同答案。
可以这样问
按导读新建对话后,发送:
接着 iobrx_skill_tutorial/results/01_rna 的本次结果,用 iobrx 比较 STAD
肿瘤样本中的免疫、基质及肿瘤相关功能。选择有文献依据的代表性签名,
用 PCA、zscore 和 ssGSEA
三种方法评分并比较,解释分数含义、方法间一致性和主要差异。保留本次
全部合格肿瘤,不参考其他案例的脚本或结果。产物保存到
iobrx_skill_tutorial/results/02_signatures,用中文说明并在对话中展示
关键图和文件链接。
Agent 根据 iobrx Skill 检查签名与输入尺度,通过 harness 完成评分,再生成方法比较图。
结果怎么看
先看用了哪些签名。 Agent 从本次资源(323 个签名)中选出 18 个有文献依据的代表签名,对 412 位患者逐个评分:
| 想观察的信号 | 签名 | 匹配基因数 | 参考来源 |
|---|---|---|---|
| CD8 效应 | CD_8_T_effector | 8/8 | Mariathasan 等,Nature 2018 |
| T 细胞炎症 | T_cell_inflamed_GEP_Ayers_et_al | 18/18 | Ayers 等,JCI 2017 |
| 成纤维细胞 TGF-β 反应 | Pan_F_TBRs | 19/19 | Mariathasan 等,Nature 2018 |
| 胃癌 TMEscore 两部分 | TMEscoreA_CIR / TMEscoreB_CIR | 62/64、172/180 | Zeng 等,CIR 2019 |
| 细胞周期 | Cell_cycle | 123/123 | IOBR 签名集合及引用表 |
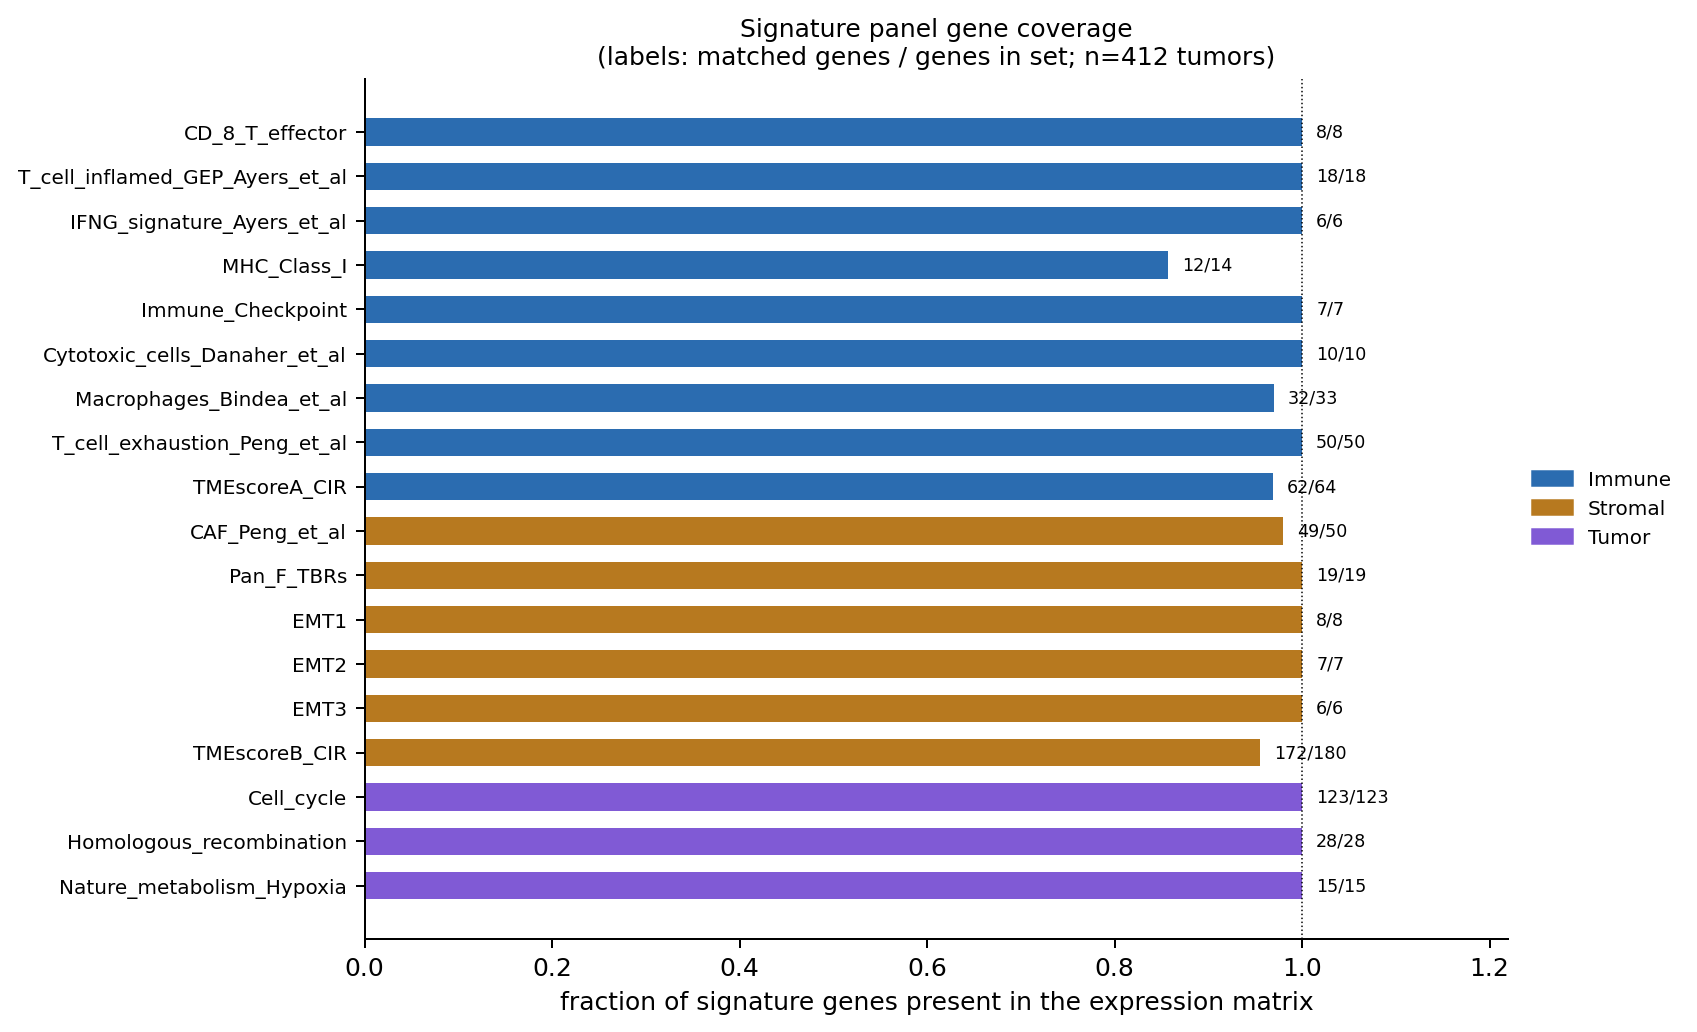
横轴是覆盖比例,"匹配数/原集合数"在右侧。覆盖 100% 只表示成员基因都找到了,不表示证明了该功能;一个只有 6 个基因的签名,也可能比一百多个基因的签名更受单个成员影响。三种方法的输出量不同:PCA/zscore 评出 311 个(至少 3 个匹配基因),ssGSEA 评出 280 个(至少 5 个)。这 18 个签名全部通过门槛。
再看三种方法各概括了什么。
| 方法 | 本次实现的读法 | 不能直接做的比较 |
|---|---|---|
| PCA | 签名基因标准化后的第一主成分 | 0 不是"没有功能";正负依赖本次队列的方向约定 |
| zscore | 匹配基因的平均表达,输入为 log2(TPM+1) | 名字叫 zscore,但不是逐基因 z 标准化;不同签名的绝对分数不能排名 |
| ssGSEA | 样本内基因表达排序的相对富集 | 不是细胞百分比,也不表示测序、细胞组成等影响已经消除 |
CAF 签名的 zscore 中位数约 6.00,免疫检查点签名约 2.24——两组基因的表达水平本来就不同,不能读成"基质功能比免疫强两倍多"。分数只支持这种问法:同一个签名里,哪些患者相对高、哪些相对低?
然后用热图读整个队列。
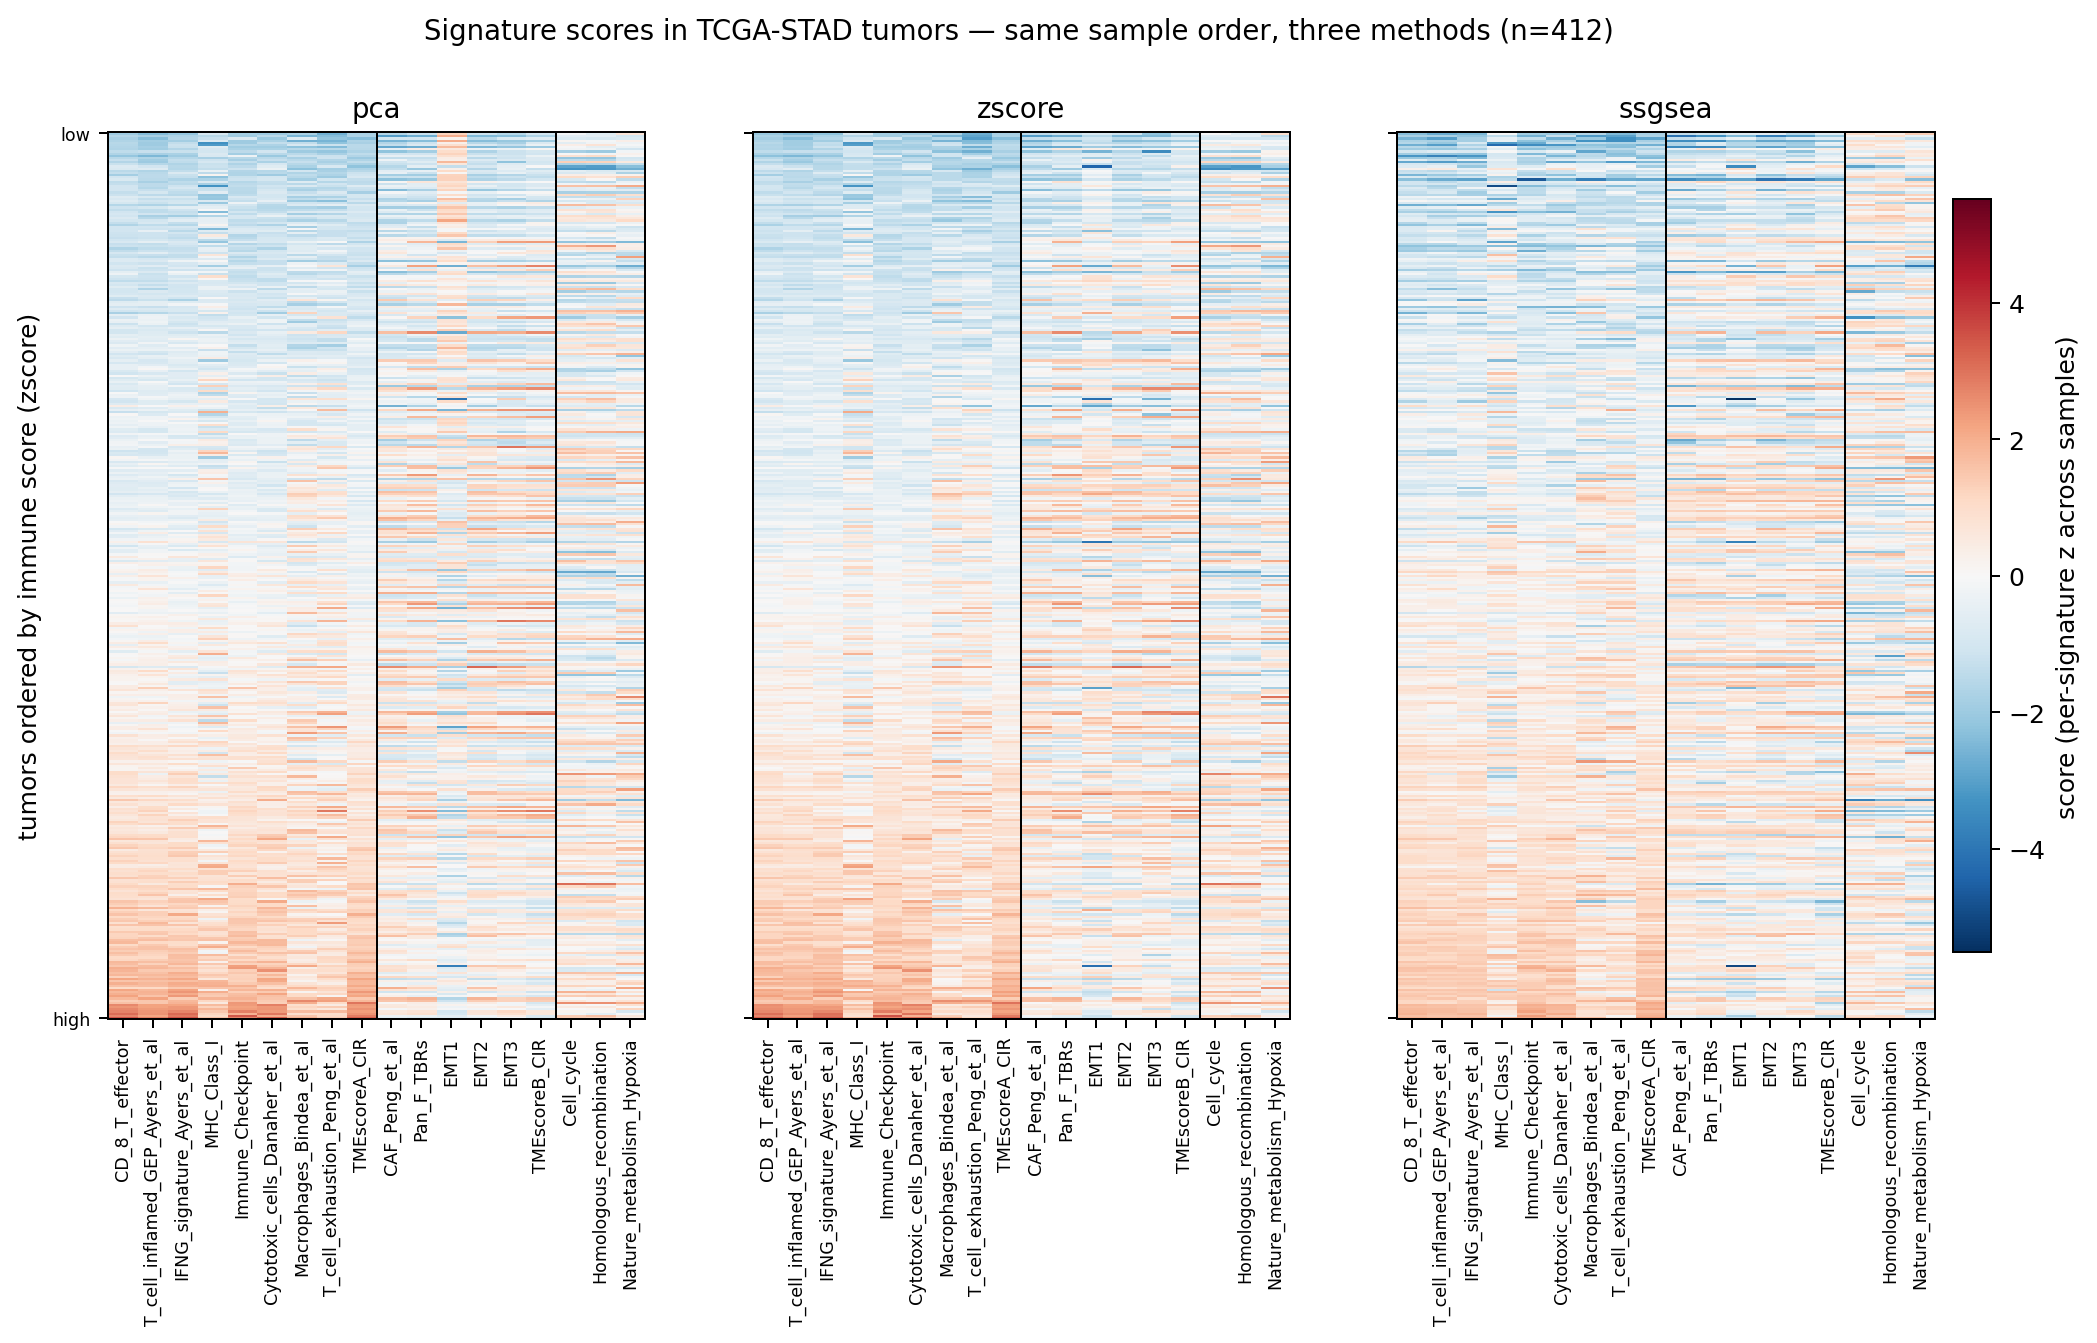
每一行是一份肿瘤,每一列是一个签名;三幅图按同一患者顺序排列(zscore 免疫签名汇总值从低到高)。为让不同量纲的列同图显示,绘图时对每列做了标准化——这与名为 zscore 的评分方法不是一回事。沿左侧免疫区域向下看,三种方法都由蓝转红;中间的基质区域却不整齐跟随,"免疫高"和"基质高"要分别观察。另外,签名之间共享成员基因会推高彼此的相关,不能把每一条相关都当成独立的生物学证据。
最后看方法比较,重点是那个例外。
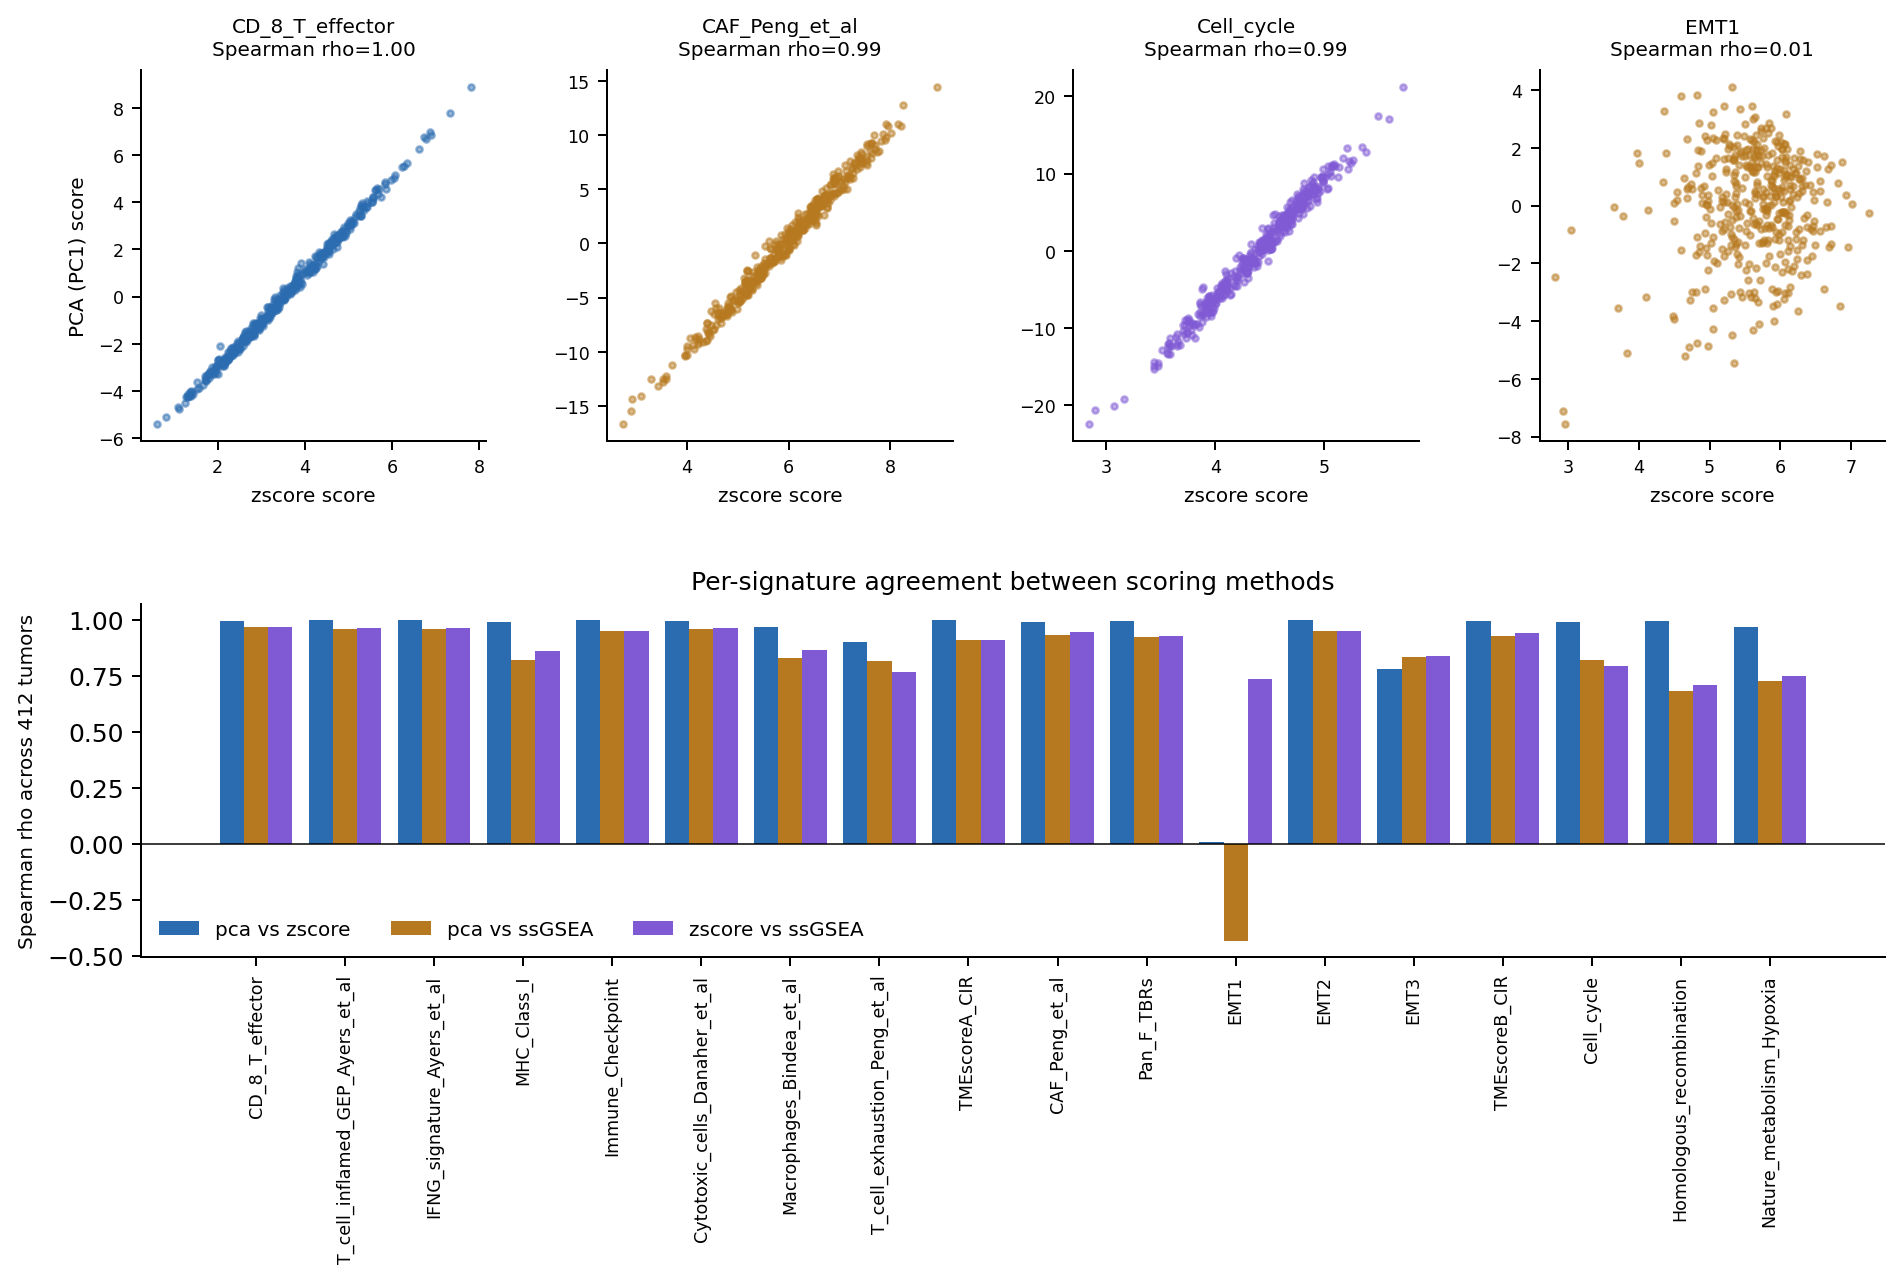
18 个签名的逐签名相关中位数:PCA–zscore 0.994,PCA–ssGSEA 0.917,zscore–ssGSEA 0.919——多数签名三种方法给出的患者排序接近。例外是右上角的 EMT1:PCA–zscore 仅 0.009,PCA–ssGSEA −0.436。它同时含上皮基因(CLDN3/4/7、CDH1)和间质基因(VIM、TWIST1、ZEB1/2),两类成员在这批样本中共变方向不同,"第一主成分"和"平均值"概括的自然不是同一件事。遇到方法分歧,先回到成员基因和算法含义,不要挑最符合预期的一列;这里的差异能解释评分方式,却不能证明肿瘤细胞发生了上皮—间质转化——bulk 数据混合了多类细胞。
接下来怎么做
签名分数不是细胞比例。接着做第 3 章 TME 反卷积,用六种方法估计细胞组成,检验这些功能读数有没有细胞层面的支持。想先核对本章,可以问:"EMT1 在三种方法下的分数散点图长什么样?"
下游合并数据时按样本 ID 对齐:prepared/panel_scores.{pca,zscore,ssgsea}.csv 是 412 位患者的面板分数,prepared/scores.signature_*.parquet 是完整分数。本次 ssGSEA 原始表按字典序排列,Agent 已把 prepared/ 重新对齐到第 1 章样本表;runs/ 里的原始记录保持原样。
参考:IOBR 签名评分方法、IOBR 2.0;运行记录见数据与运行说明。