01 · 手上的公开数据,够不够开始这项研究?
做 CADD,先弄清数据从哪里来、每个数值代表什么。本节整理人 EGFR(一种参与细胞生长信号的蛋白)的活性记录,核对分子身份,为后续分析准备有来源、可复查的数据。
发什么提示词
新建对话,选择 CADD Workflow Runner。
发送:
研究 EGFR(UniProt P00533,ChEMBL CHEMBL203)的公开活性。请自行从 ChEMBL 获取记录,并用 PubChem 核对分子身份。整理去重后的数据表,画出活性和分子性质分布,说明数据量、字段和质量问题,并给出下一步可直接使用的输出。请在会话中完成检索、计算和作图,注明数据来源与查询时间。
结果出来后,可以追问:
图 1 里 133 个 IC50 不一致的分子,会影响后面哪一步?
读懂结果
ChEMBL 提供活性与实验记录,PubChem 帮助核对分子身份。靶点编号为 UniProt P00533、ChEMBL CHEMBL203。
| 输入 | 本次使用的内容 | 用途 |
|---|---|---|
| ChEMBL27 下载快照 | 7,178 行活性记录,包含分子、实验、测量与单位字段 | 重建原方法的整理过程,保留实验来源。 |
| 原教程小分子表 | 5,568 个小分子及 SMILES、IC50、pIC50 | 保留与后续原教程比较的共同基准。 |
| 带日期的公开查询缓存 | 30 个身份观测、10 个 gefitinib(吉非替尼,已上市的 EGFR 抑制剂)相似性命中及请求日志 | 核对受检分子的身份,理解跨库连接与相似性。 |
1. 两份分子表对得上吗?
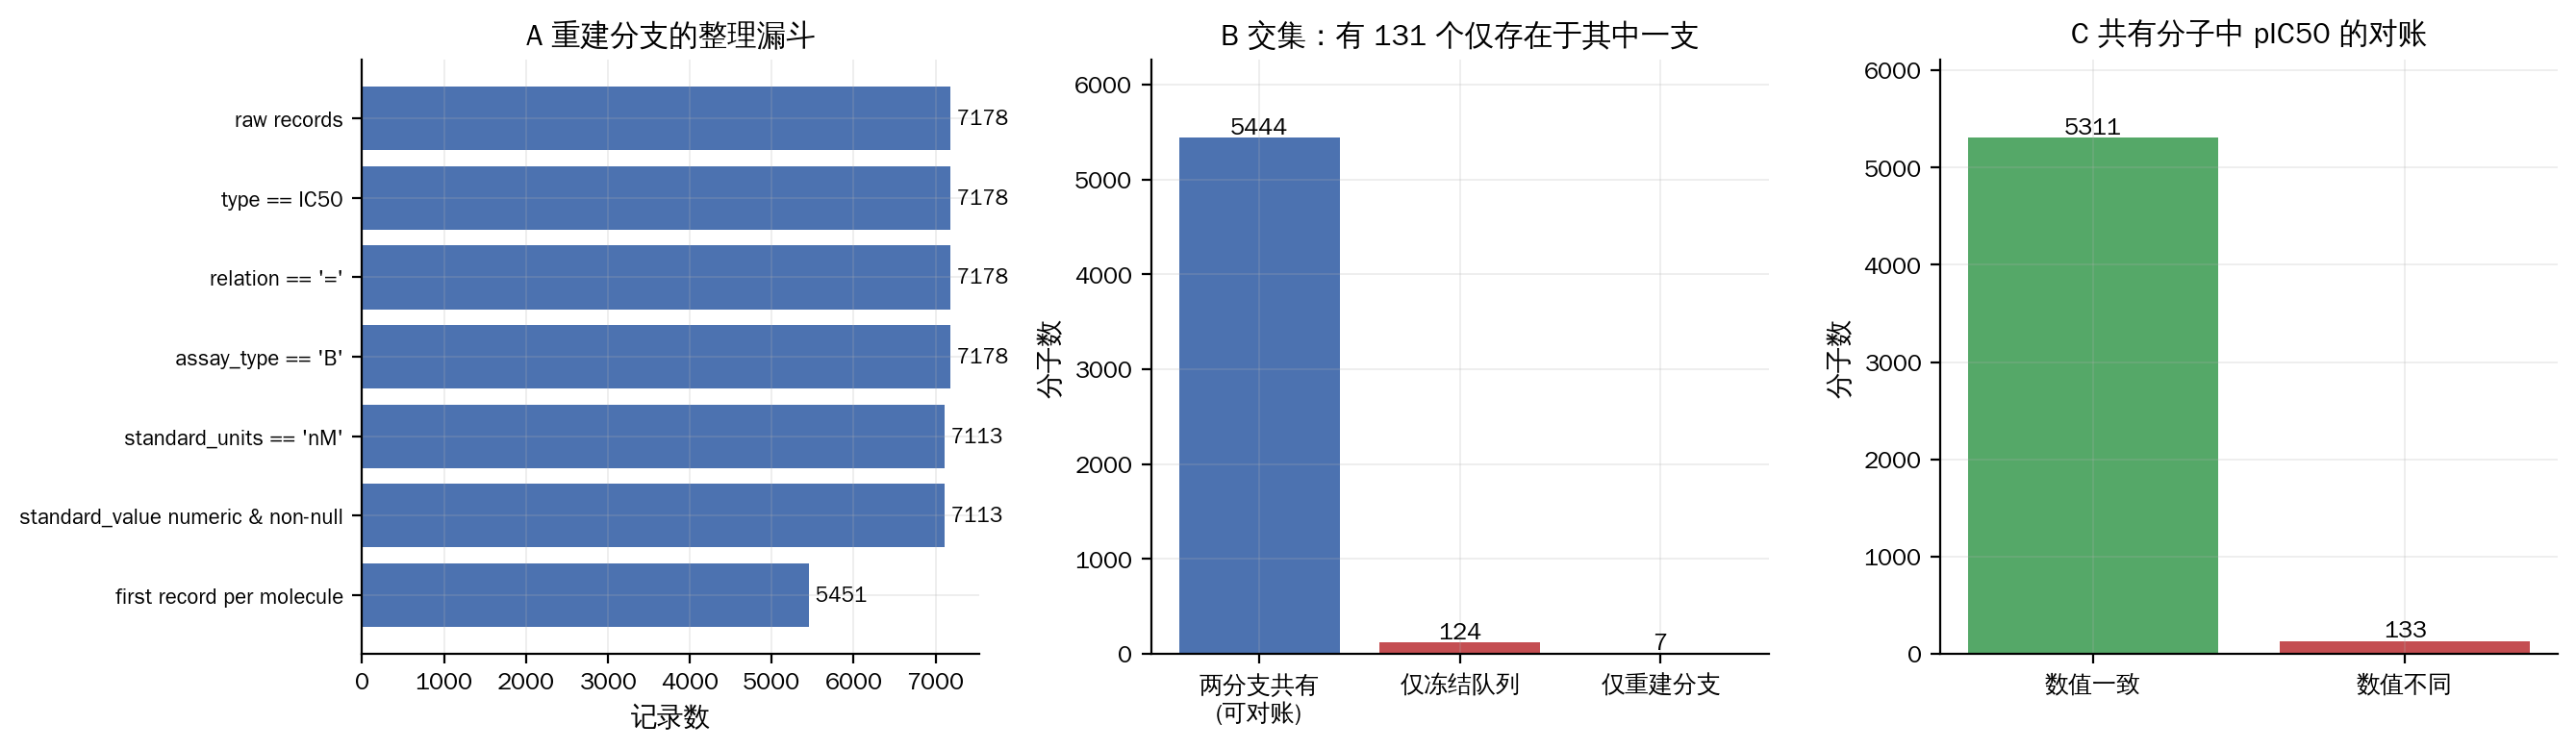
图 1|A:记录整理与去重;B:两份表各有哪些分子;C:共有分子的 IC50 对账。B、C 都按分子计数。
- 这张图看什么: A 是记录整理与去重,B 看两份表各有哪些分子,C 对账共有分子的 IC50;B、C 都按分子计数。
- 看到什么: 从原始快照的 7,178 行中保留 7,113 条 nM 记录,按源顺序每个分子取首行,得到 5,451 个分子。原教程保存的表有 5,568 个分子,两者共有 5,444 个,其中 133 个 IC50 不同;另有 124 个仅在原教程分子表、7 个仅在重建表。这说明重建表没有完全复现原教程表。两份表分别保存,后续采用哪份都注明来源。
补充说明
不一致的原因仍需查询历史与实验记录,不能直接归因于某次测量或软件版本。2. 活性数值和实验条件怎么看?
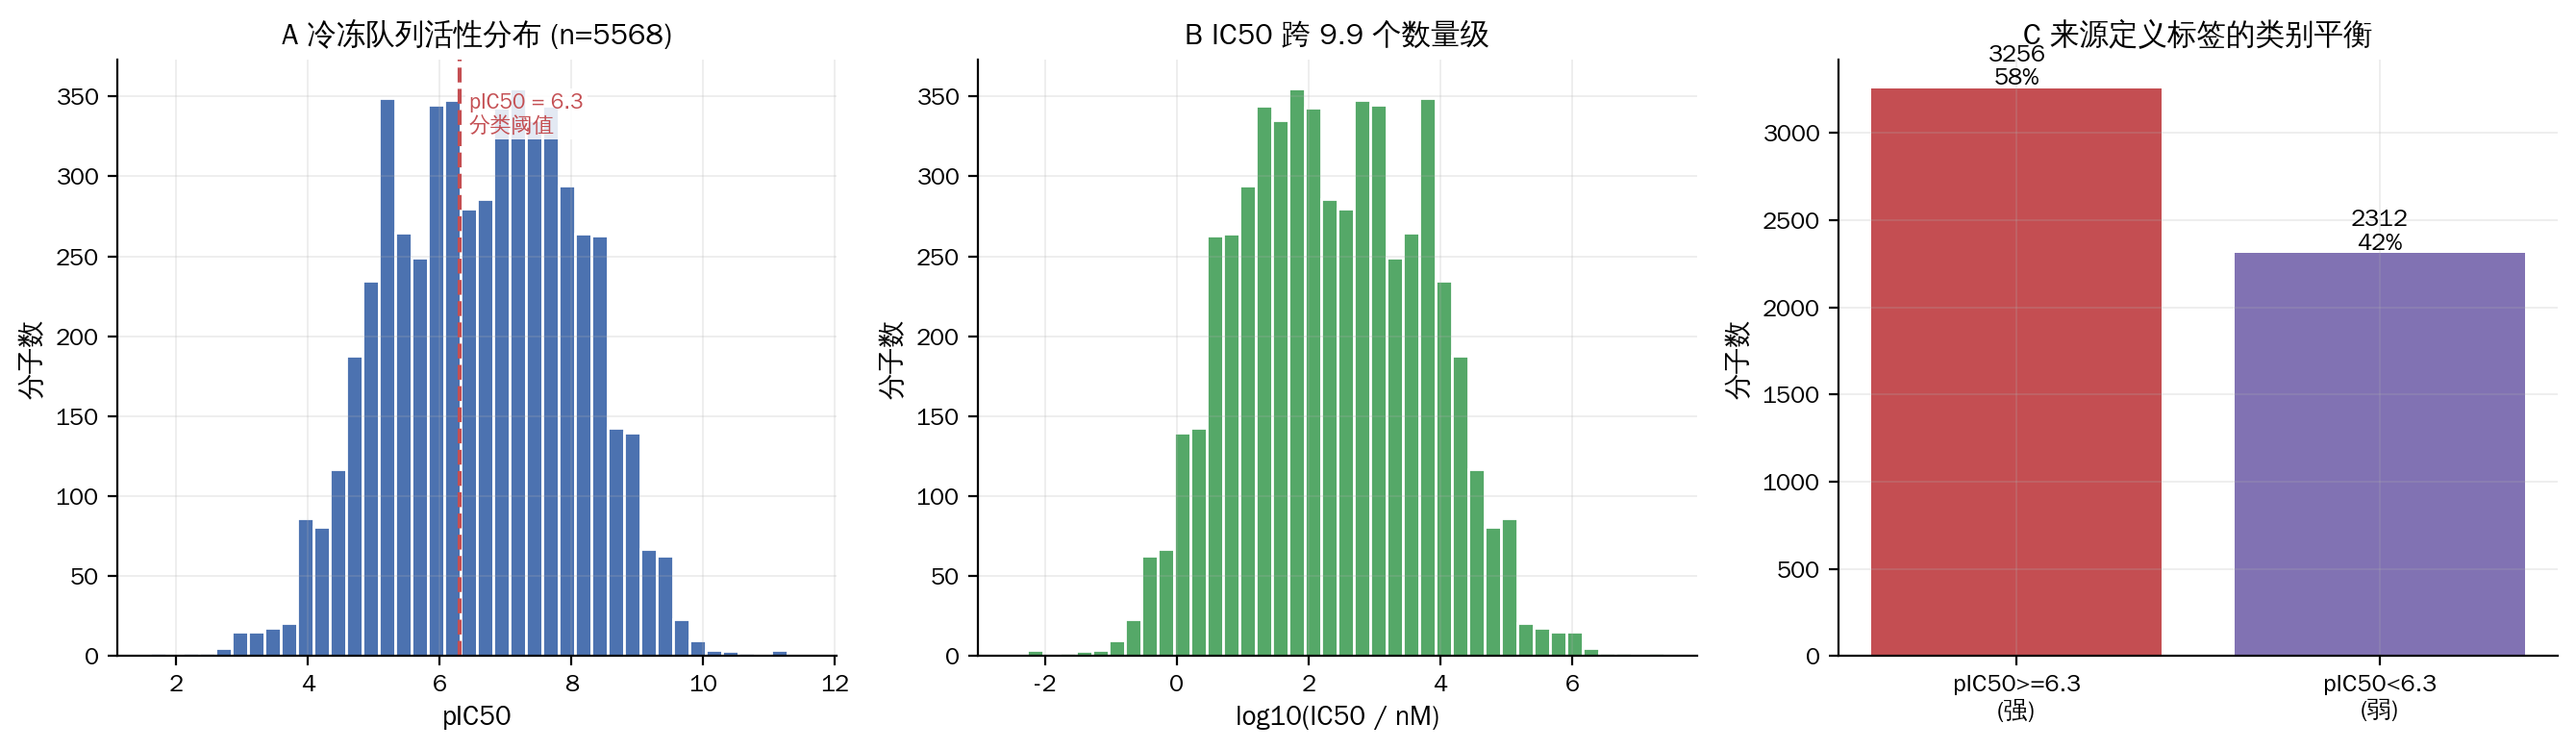
图 2|A、B 从两个对数方向观察同一批分子的活性;C 为后续分类练习准备标签。
- 这张图看什么: A、B 从两个对数方向观察同一批分子的活性,C 为后续分类练习准备标签。IC50 是在特定实验中将测定活性抑制一半所需的浓度,越小通常表示效力越强;nM 是纳摩尔/升;
pIC50 = 9 − log10(IC50/nM):1,000、100、10 nM 分别对应 6、7、8,pIC50 增加 1,IC50 降低十倍。 - 看到什么: 原教程分子表的 pIC50 中位数约 6.70、范围 1.60–11.52;按教学规则 pIC50 ≥ 6.3,得到 3,256 个阳性、2,312 个阴性。原始快照涉及 745 个 assay ID。
补充说明
这个界线不是临床药效标准。原教程表未保留实验字段,不能默认所有值来自可直接比较的条件;同一分子的多次记录也不自动等于同条件重复。3. 结构能解析,就表示完整了吗?
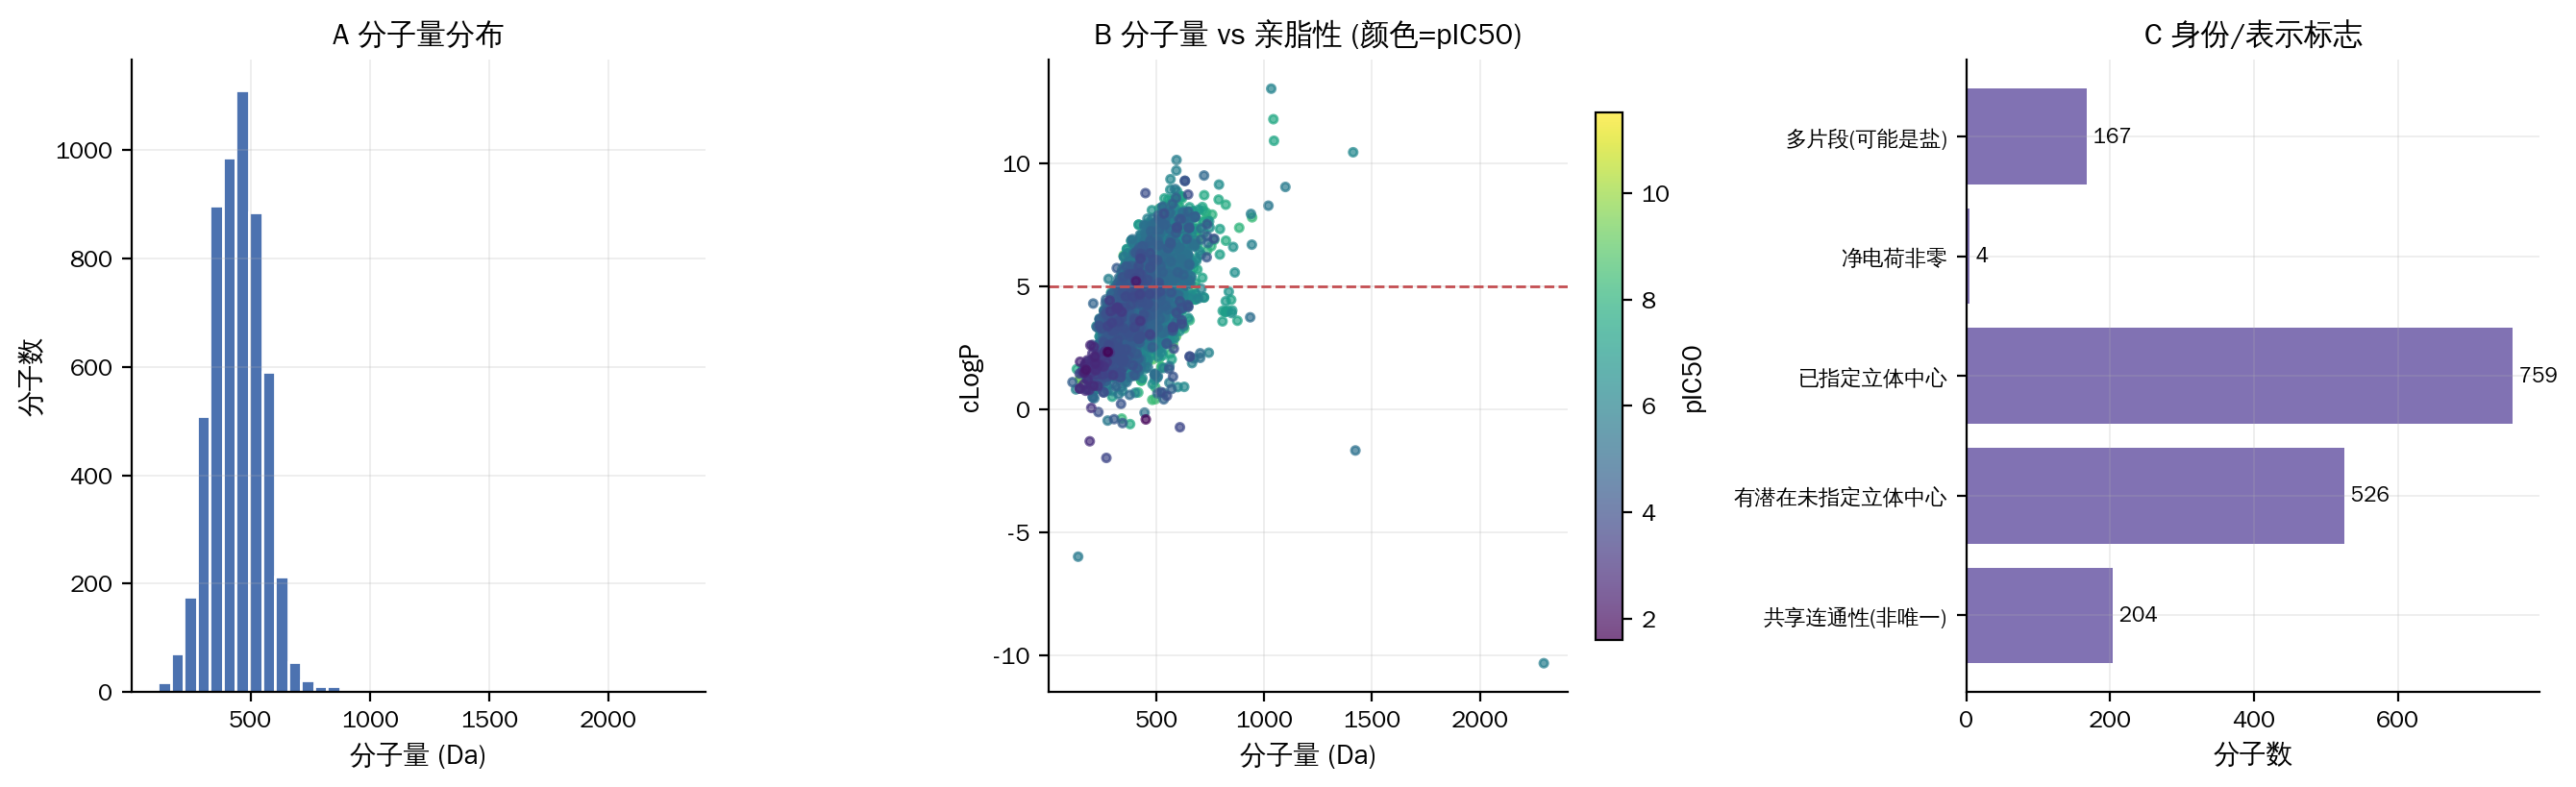
图 3|A、B 描述这批分子的计算性质;C 提醒后续分析注意化学表示。C 的类别可能重叠,不能相加当作“有问题的分子总数”;多片段不自动等于盐,电荷计数指总形式电荷非零。
- 这张图看什么: A、B 描述这批分子的计算性质,C 提醒后续分析注意化学表示。SMILES 是分子结构的文字写法,InChIKey 是常用于跨库核对结构的编码。
- 看到什么: 5,568 个 SMILES 均可解析,完整 InChIKey 也各不相同。检查发现 167 个多片段分子、4 个总形式电荷非零的分子;759 个分子有已指定的四面体手性中心,526 个分子有潜在但未指定构型的中心。另有 94 组、共 204 行共享 InChIKey 连接层。
补充说明
可解析、编码各不相同,仍不等于完成了实验身份鉴定。这里数的是分子,不是手性中心总数,各类可能重叠;连接层关注原子连接,不等于 Murcko 骨架(保留环系及连接环系的链),不能据此合并不同的立体异构体。4. 跨库核对能外推到所有分子吗?
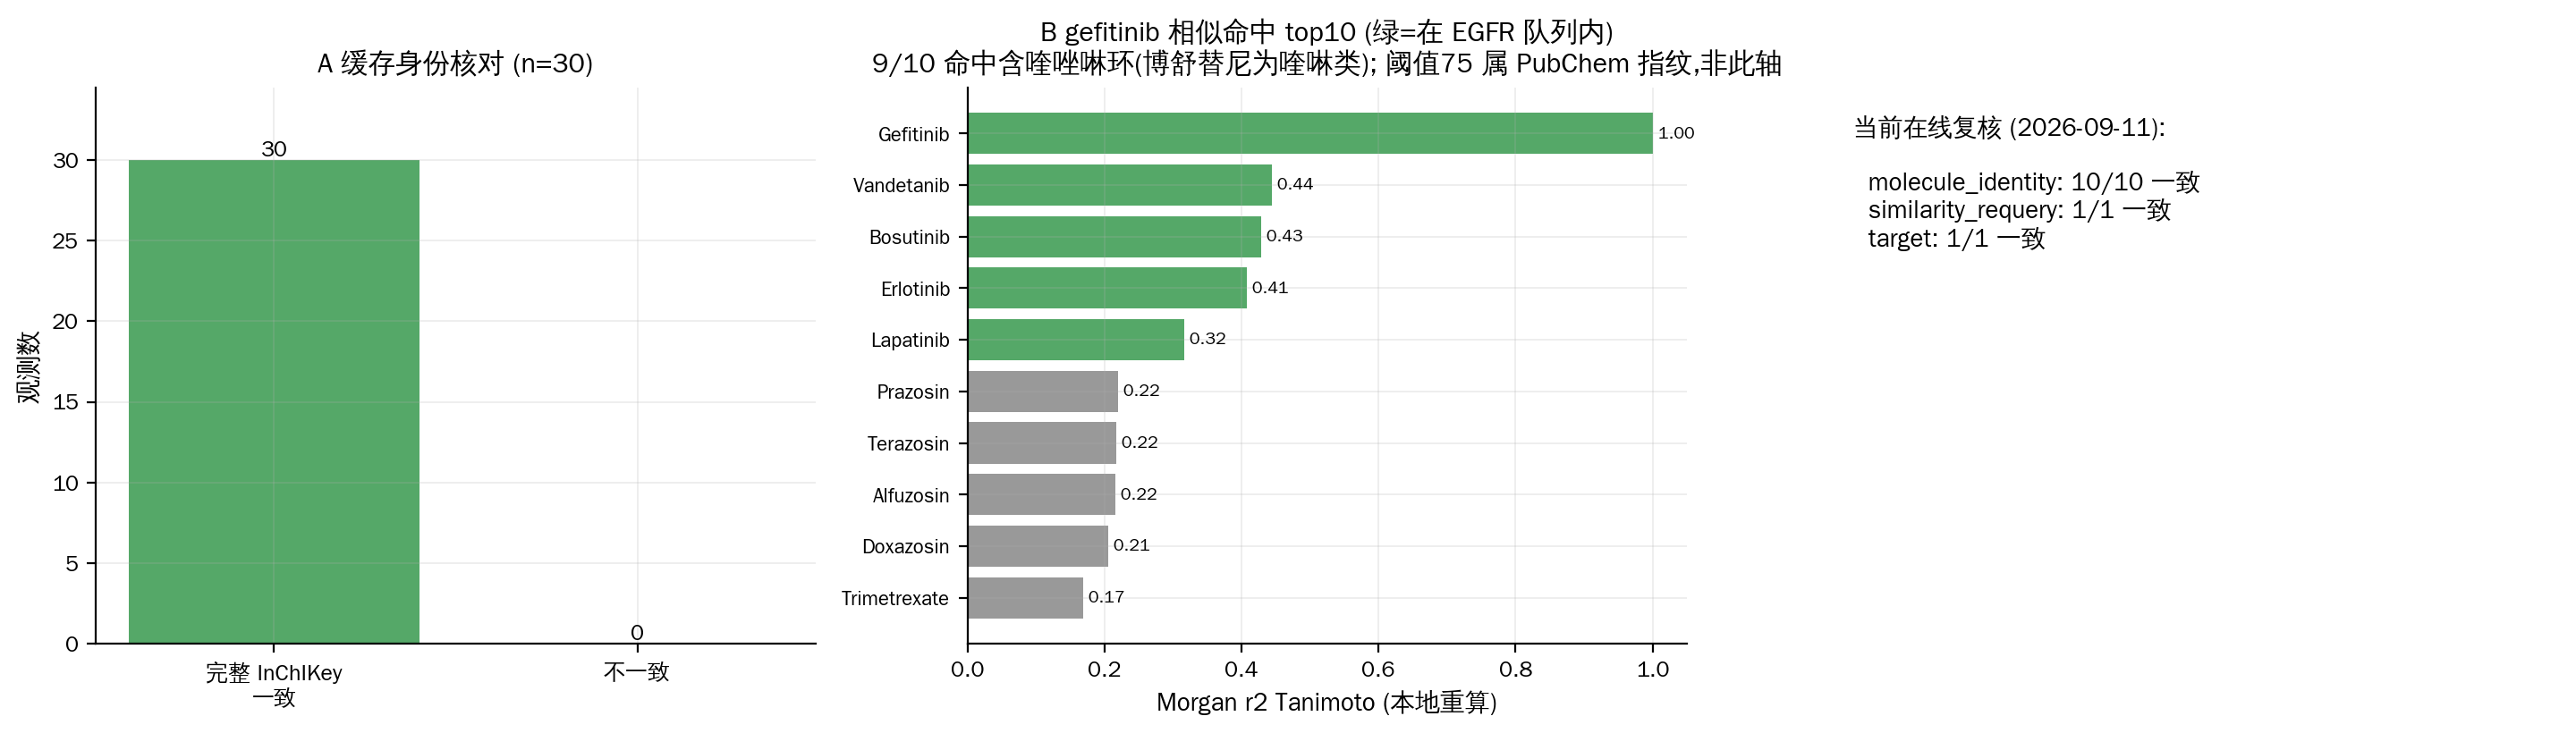
图 4|A 为缓存中 30 个分子的身份核对;B 是 gefitinib 相似性检索的 10 个命中,颜色表示能否连接到当前队列;C 为追加在线复核的 12 项。各面板分母不同。
- 这张图看什么: A 是缓存中 30 个分子的身份核对,B 是 gefitinib 相似性检索的 10 个命中(颜色表示能否连接到当前队列),C 是追加在线复核的 12 项;各面板分母不同。
- 看到什么: 本地重算的 InChIKey 与 PubChem 缓存中的 30 个受检分子全部一致;查询日期为 2026-09-11,同日追加核对的 12 项也一致,范围见图 C。以吉非替尼(gefitinib)检索的 10 个命中中,5 个能连回当前 EGFR 队列;图 B 的条长是本地 Morgan 指纹的 Tanimoto 相似度。
补充说明
核对结论只覆盖受检样本:30 个受检分子全部一致,不能外推到全部 5,568 个。条长不能与 PubChem 检索阈值 75 混用。未收录不等于无活性,结构相似也不保证作用于同一靶点。下一步
后续分子分析以原教程的 5,568 个分子为参考;结构分析与筛选另用各节注明的数据。继续第二节:一个分子,怎么变成能分析的数字、字符串和图?,比较分子性质、结构警示、指纹和共同子结构。去之前可以先发一句追问,把数据起点定下来:
两份分子表有 133 个 IC50 不一致,下一步分析该用哪一份、为什么?
下载第一节结果包,解压后先打开 readable-report.html。
| 想检查什么 | 打开哪个文件 |
|---|---|
| 下一步使用的 5,568 个分子 | data/egfr_activity_curated.csv |
| 从原始记录独立重建的分支 | data/egfr_activity_reconstructed_from_raw.csv |
| 两份表的差异 | data/cohort_reconciliation.csv |
| 每列代表什么 | data/dictionary.md |
| 计算怎样执行 | scripts/01_curate_egfr_activity_identity.py |
原始教学内容:原教程 T001、原教程 T011、原教程 T013。
返回指南首页。